AI-краулери в robots.txt налаштовують окремими правилами для кожного типу доступу. Так можна дозволити пошуковому боту знаходити сайт, але обмежити краулер, який збирає матеріали для навчання моделей. Для цього потрібно знати, який user-agent відповідає за кожну дію, і перевірити правила для потрібного хоста.
Нижче є список AI-ботів для robots.txt і приклади правил для GPTBot, OAI-SearchBot, ClaudeBot, PerplexityBot і Google-Extended. robots.txt задає інструкції сумісним краулерам, але не захищає приватні сторінки паролем.
Що саме контролює robots.txt
Файл robots.txt лежить у корені сайту, наприклад https://example.com/robots.txt. Його читають боти, щоб дізнатися, які URL власник сайту дозволяє сканувати, а які ні.
Базовий формат простий:
User-agent: ExampleBot
Disallow: /private/
Allow: /blog/

Sitemap: https://example.com/sitemap.xml
Кожна група починається з User-agent. Краулер виконує ту групу, де вказано його token (назву бота для robots.txt). User-agent: * задає типові правила для ботів, яким не відведено окремої групи. Як бот обирає групу і зіставляє шляхи, описує RFC 9309, стандарт файлу robots.txt.
Чим robots.txt відрізняється від llms.txt, видно з окремого матеріалу про те, як створити llms.txt і для чого він потрібен.
У RFC 9309 зазначено, що ці правила не є засобом контролю доступу. robots.txt не закриває сторінку від людини, не ставить пароль і не гарантує, що кожен бот виконає інструкцію.
Файл допомагає керувати краулерами, які дотримуються його правил. Приватні матеріали захищайте автентифікацією, обмеженням доступу на сервері або міжмережевим екраном (WAF). noindex керує показом у пошуку, але не захищає сторінку. Якщо URL має бути приватним, використовуйте контроль доступу.
Правила діють для конкретного протоколу, хоста і порту. Файл https://example.com/robots.txt не керує піддоменом https://blog.example.com/; для HTTP та HTTPS також потрібні окремі файли. Це пояснює документація Google про область дії robots.txt.
Чому AI-краулери мають різні ролі
Один сервіс може мати кілька user-agent (так бот називає себе в HTTP-запиті), кожен для своєї задачі:
- навчання або вдосконалення базових моделей;
- індексація для AI-пошуку;
- відкриття сторінки за прямим запитом користувача;
- технічна перевірка сторінок, реклами або безпеки.
Наприклад, власник сайту може дозволити OAI-SearchBot для пошукових відповідей ChatGPT і окремо заблокувати GPTBot для навчального використання контенту. Рішення щодо кожного user-agent ухвалюють окремо.
Тому не варто обмежуватися одним загальним блоком:
User-agent: *
Disallow: /
Таке правило закриє сайт для всіх сумісних краулерів, зокрема Googlebot. Якщо сайт має лишатися в Google Search, не ставте такого правила, не перевіривши наслідків.
Навчання, AI-пошук і завантаження за запитом користувача: у чому різниця
Розрізняйте три види доступу: збір матеріалів для навчання, сканування для пошукових відповідей і відкриття сторінки на прохання користувача.

| Сценарій | Що відбувається | Для чого це бізнесу |
|---|---|---|
| Навчання моделей | Краулер збирає публічний контент, який можуть використати для навчання або вдосконалення майбутніх моделей | Ви вирішуєте, чи віддавати свої матеріали для навчання |
| AI-пошук та індексація | Сервіс обходить сторінки, щоб показувати сайт у відповідях, джерелах і посиланнях | Видимість бренду в ChatGPT Search, Claude, Perplexity та інших AI-пошукових сервісах |
| Завантаження за запитом користувача | Користувач просить AI відкрити конкретний URL або виконати дію, і бот приходить за цією сторінкою | Сайт доступний у діалогах, коли користувач сам просить відкрити сторінку |
Від цієї різниці залежить, чи потраплять ваші сторінки в пошукові відповіді. Як AI-відповіді змінюють пошук загалом, пояснює матеріал про AI-видимість і SEO.
Основні AI-краулери в robots.txt
Ролі в таблиці взято з офіційних інструкцій платформ станом на жовтень 2026 року. Перелік охоплює основні пошукові та навчальні user-agent, а не всіх ботів в інтернеті.
| Компанія | User-agent або token | Роль за документацією | Що означає блокування |
|---|---|---|---|
| OpenAI | GPTBot | Збирає контент, який може використовуватися для навчання базових моделей | Вказує, що контент не слід використовувати для такого навчання |
| OpenAI | OAI-SearchBot | Допомагає показувати сайти в пошукових відповідях ChatGPT | Сайт може не з'являтися у відповідях ChatGPT Search, хоча може лишатися навігаційним посиланням |
| OpenAI | ChatGPT-User | Відкриває сторінку після дії користувача в ChatGPT чи Custom GPT | Правила robots.txt можуть не застосовуватися до дій, які запустив сам користувач |
| Anthropic | ClaudeBot | Збирає вебконтент, який може використовуватися для навчання моделей | Сигнал не використовувати нові матеріали сайту для навчання |
| Anthropic | Claude-SearchBot | Сканує сторінки для пошуку Claude | Сторінки сайту можуть не потрапляти в пошукові відповіді Claude |
| Anthropic | Claude-User | Відкриває сторінку за запитом користувача Claude | Claude може не отримати сторінку у відповідь на запит користувача |
| Perplexity | PerplexityBot | Сканує сторінки для пошукових результатів Perplexity | Сайт може не показуватися в результатах Perplexity |
| Perplexity | Perplexity-User | Отримує сторінку, коли користувач просить Perplexity її відкрити | Perplexity зазначає, що такі запити зазвичай не зважають на robots.txt |
Google-Extended | Token у robots.txt, який керує використанням контенту в Gemini Apps і Vertex AI | Не керує включенням сайту в Google Search і не є сигналом ранжування | |
| Apple | Applebot | Сканує вебсторінки для пошукових функцій екосистеми Apple | Сайт може зникнути з відповідних результатів Apple |
| Apple | Applebot-Extended | Token, яким можна відмовитися від використання контенту для навчання моделей Apple | Контент, зібраний Applebot, не має використовуватися для навчання моделей Apple |
| Common Crawl | CCBot | Збирає сторінки для відкритого вебархіву Common Crawl | Common Crawl припиняє нове сканування сторінок, що підпадають під правило |
| Amazon | Amazonbot, Amzn-SearchBot, Amzn-User | Сканування для Amazon та доступ за запитом користувача | Відповідні Amazon-сервіси можуть не отримати сторінку |
OpenAI розділяє GPTBot і OAI-SearchBot: GPTBot стосується навчання, а OAI-SearchBot працює для пошуку ChatGPT. Джерела: документація OpenAI, довідка Anthropic про краулери, документація Perplexity, список краулерів Google, документація Applebot, довідка Common Crawl про CCBot і інструкція Amazonbot.
OpenAI: GPTBot, OAI-SearchBot і ChatGPT-User
OpenAI розділяє пошук і навчання: OAI-SearchBot допомагає показувати сайти в ChatGPT Search, а GPTBot сканує контент, який може використовуватися для навчання моделей. Це підтверджує документація OpenAI про краулери.
Дозвіл для OAI-SearchBot дає змогу ChatGPT знаходити сайт, але не гарантує показу кожної сторінки у відповіді.
Як налаштувати GPTBot у robots.txt
Створіть для GPTBot окрему групу й укажіть, які шляхи йому можна сканувати. Якщо треба заборонити доступ до всього сайту, додайте Disallow: /.
Як дозволити OAI-SearchBot у robots.txt
Створіть для OAI-SearchBot окрему групу. GPTBot тримайте у власній групі, якщо правила для пошуку й для збору даних на навчання мають відрізнятися:
User-agent: OAI-SearchBot
Allow: /

User-agent: GPTBot
Disallow: /
Правило не гарантує згадку бренду у відповіді ChatGPT. OpenAI попереджає: якщо заблокувати OAI-SearchBot, сайт не показуватиметься в пошукових відповідях, але ще може з'являтися як навігаційне посилання.
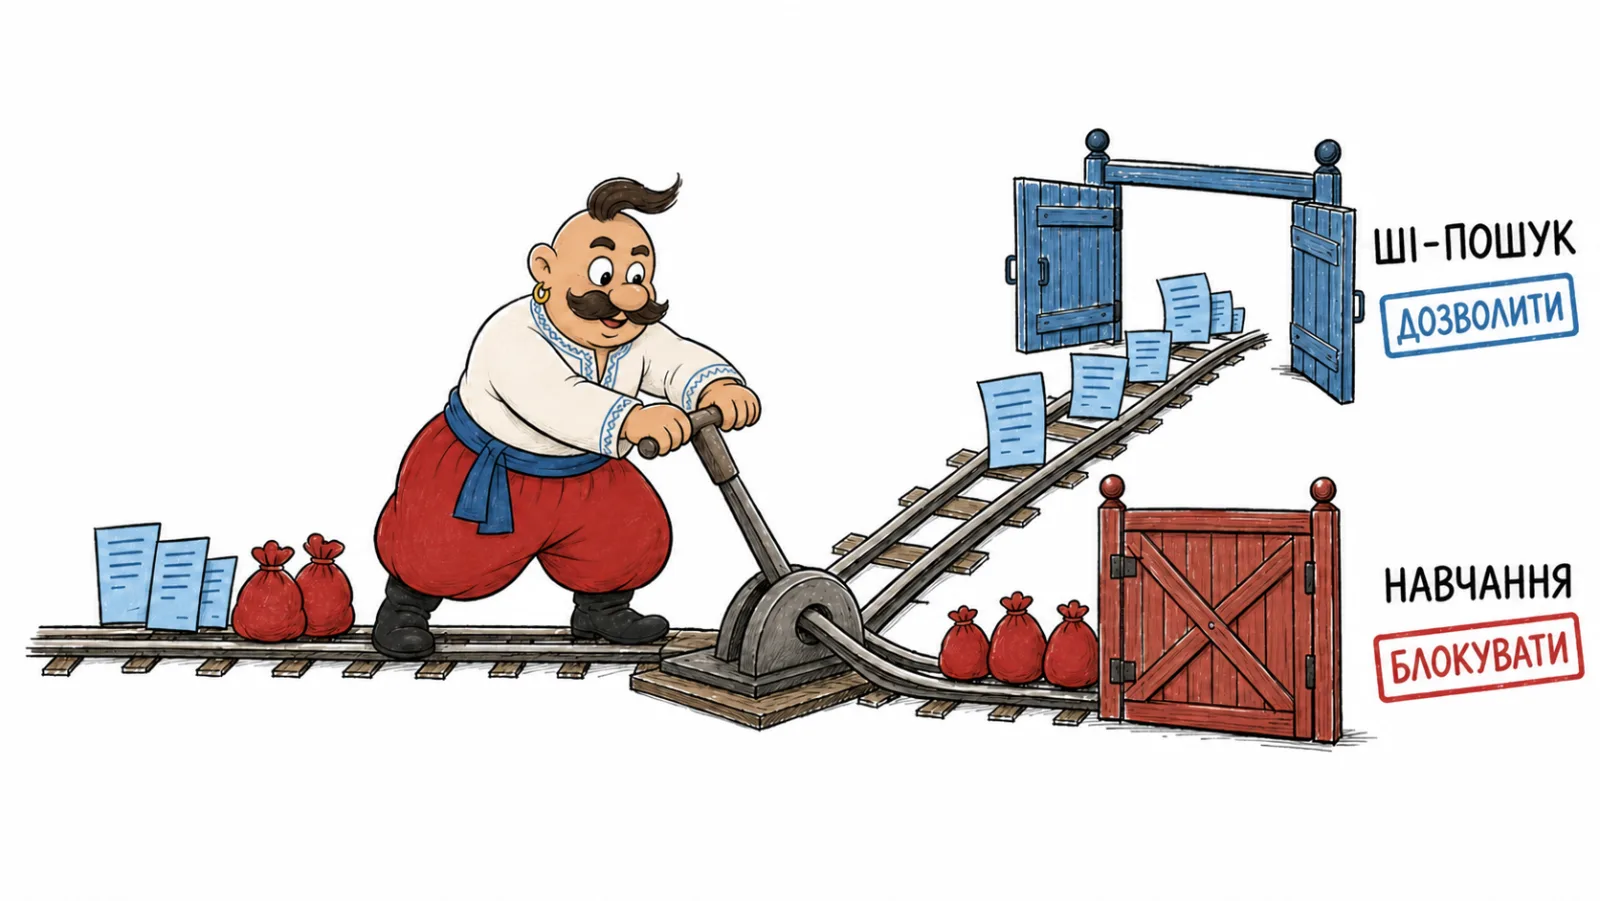
ChatGPT-User відкриває сторінки після дії користувача в ChatGPT або Custom GPTs. OpenAI зазначає, що до таких запитів правила robots.txt можуть не застосовуватися, тому для приватних сторінок використовуйте контроль доступу на сервері.
Anthropic: ClaudeBot, Claude-SearchBot і Claude-User
Anthropic описує різні ролі у довідці про вебкраулери Claude: ClaudeBot збирає вебконтент для можливого навчання, Claude-SearchBot покращує пошук у Claude, а Claude-User відкриває сторінки за запитом користувача.
Як заблокувати ClaudeBot у robots.txt
Створіть для нього окрему групу. Якщо сторінки мають бути доступними для пошуку Claude, залиште Claude-SearchBot дозволеним:
User-agent: ClaudeBot
Disallow: /

User-agent: Claude-SearchBot
Allow: /

User-agent: Claude-User
Allow: /
Не блокуйте IP краулера на міжмережевому екрані, якщо очікуєте, що він прочитає нову інструкцію з /robots.txt. Сам файл має залишатися доступним.
PerplexityBot і Perplexity-User
За документацією Perplexity про краулери, PerplexityBot сканує сторінки, щоб вони могли з'являтися в результатах Perplexity. Документація окремо зазначає, що цей бот не сканує контент для навчання базових моделей.
Як керувати PerplexityBot у robots.txt
Додайте окрему групу для цього user-agent і задайте доступ згідно зі своєю політикою.
User-agent: PerplexityBot
Allow: /
Perplexity-User відкриває сторінку за запитом людини. Perplexity зазначає, що такі звернення зазвичай ігнорують правила robots.txt. Для чутливих сторінок потрібні пароль або серверне обмеження доступу.
Правило для Perplexity-User можна додати як інструкцію, але приватного розділу воно не захистить:
User-agent: Perplexity-User
Disallow: /clients/
Захистіть /clients/ автентифікацією на сервері.
Google-Extended: не плутати з Googlebot
Google-Extended не має окремого HTTP user-agent. Google описує його як token для robots.txt, а самі сторінки сканують звичайні боти Google. Це пояснено в документації Google про Google-Extended. Щоб налаштувати Google-Extended у robots.txt, створіть для нього окрему групу.
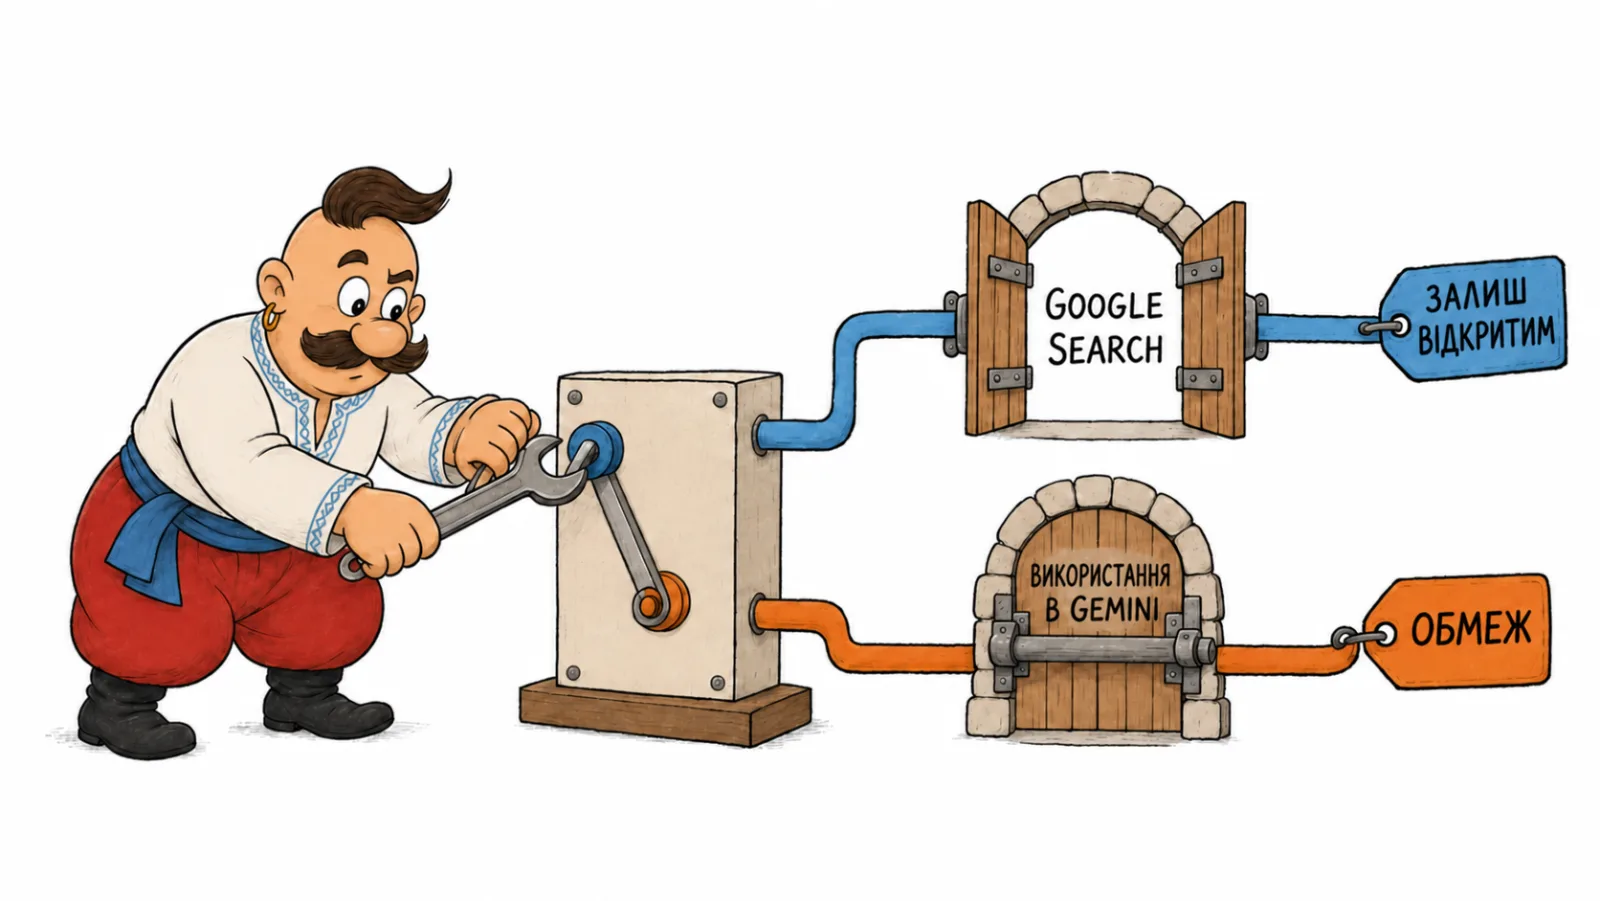
Google-Extended дає змогу керувати використанням уже просканованого контенту в Gemini Apps і Vertex AI. Він не керує включенням сайту в Google Search і не є сигналом ранжування. Google AI Overviews і AI Mode належать до функцій Google Search; як керувати фрагментами й використанням сторінки в цих функціях, описує документація Google про robots meta directives (метатеги robots).
Якщо хочете залишити звичайний Google Search відкритим, але обмежити Google-Extended:
User-agent: Googlebot
Allow: /

User-agent: Google-Extended
Disallow: /
Якщо ж написати Googlebot замість Google-Extended, ви обмежите сканування для самого Google Search.
Готові сценарії robots.txt
Кожен шаблон нижче описує окрему політику. Перед публікацією перевірте, які правила застосовуються до потрібного URL і user-agent.
Сценарій 1. Дозволити AI-пошук, але закрити навчання
Цей варіант залишає доступ пошуковим краулерам, але обмежує використання контенту для навчання моделей і в Gemini.
User-agent: OAI-SearchBot
Allow: /

User-agent: Claude-SearchBot
Allow: /

User-agent: PerplexityBot
Allow: /

User-agent: GPTBot
Disallow: /

User-agent: ClaudeBot
Disallow: /

User-agent: Google-Extended
Disallow: /
Дозвіл не гарантує появи сторінок у відповідях. Щоб перевірити, які джерела цитують моделі, дивіться методику аналізу джерел відповідей ШІ.
Сценарій 2. Закрити основних AI-ботів повністю
Підходить для сайту, якому не потрібна AI-видимість, або для контенту з підвищеним ризиком копіювання.
User-agent: GPTBot
Disallow: /

User-agent: OAI-SearchBot
Disallow: /

User-agent: ChatGPT-User
Disallow: /

User-agent: ClaudeBot
Disallow: /

User-agent: Claude-SearchBot
Disallow: /

User-agent: Claude-User
Disallow: /

User-agent: PerplexityBot
Disallow: /

User-agent: Perplexity-User
Disallow: /

User-agent: Google-Extended
Disallow: /
OpenAI зазначає, що блокування OAI-SearchBot прибирає сайт із пошукових відповідей ChatGPT, хоча він може залишитися навігаційним посиланням. Як поводяться інші платформи, дивіться в їхній документації.
Сценарій 3. Закрити лише окремі розділи
Підходить, коли блог, документацію і сторінки послуг можна відкрити, а службові, клієнтські чи архівні розділи треба закрити.
User-agent: GPTBot
Disallow: /clients/
Disallow: /internal/
Allow: /blog/
Allow: /services/

User-agent: OAI-SearchBot
Disallow: /clients/
Disallow: /internal/
Allow: /
Перевірте, як кожен краулер застосовує правила Allow і Disallow, перш ніж публікувати такий шаблон.
Сценарій 4. Залишити Google Search відкритим і обмежити Google-Extended
Підходить, коли сайт має залишатися в Google Search, але команда хоче обмежити Google-Extended.
User-agent: Googlebot
Allow: /

User-agent: Google-Extended
Disallow: /
Для шляхів діє правило з найдовшим збігом, а регістр літер має значення. Це визначає RFC 9309 і пояснює специфікація Google про robots.txt. Тому для /blog/ і /Blog/ можуть спрацювати різні правила.
Як перевірити, що правила справді працюють
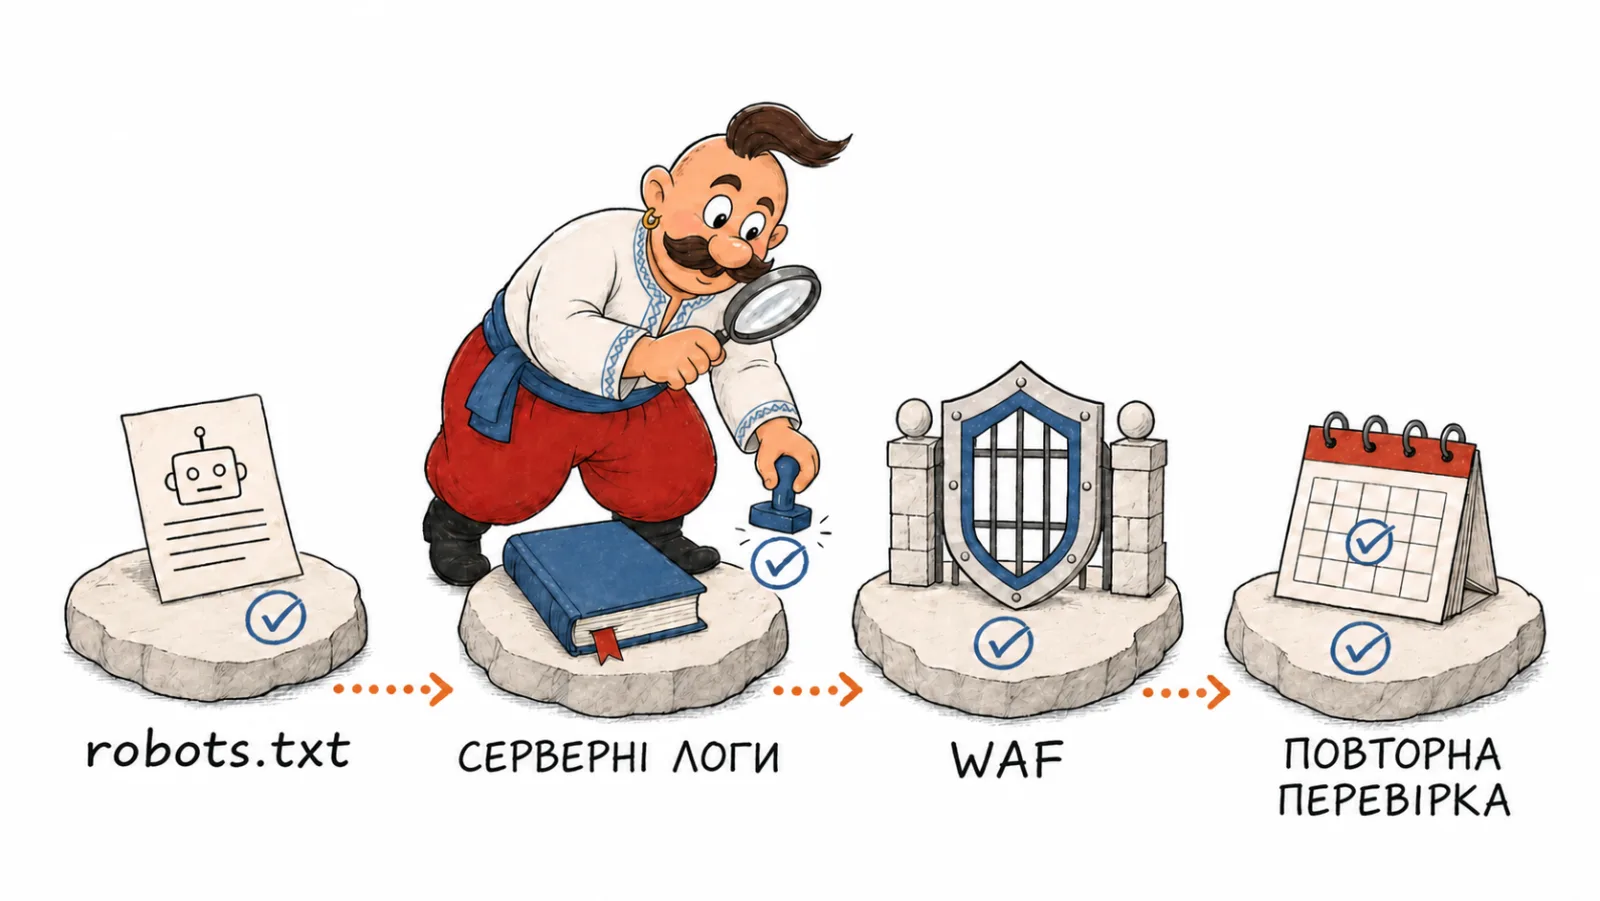
Після публікації перевірте, чи файл відкривається, і подивіться на реальні запити до сайту.
- Відкрийте
https://domain.com/robots.txtу браузері. Переконайтеся, що сервер повертає файл, а не HTML-сторінку помилки чи відмову в доступі. - Перевірте правила для кожного піддомену. Якщо блог працює на
blog.example.com, йому потрібен власнийrobots.txt. - Подивіться серверні логи за user-agent:
GPTBot,OAI-SearchBot,ChatGPT-User,ClaudeBot,Claude-SearchBot,Claude-User,PerplexityBot,Perplexity-User,Googlebot. OpenAI зазначає, щоChatGPT-Userможе не підпорядковуватисяrobots.txt, а Perplexity каже, щоPerplexity-Userзазвичай ігнорує його правила (OpenAI, Perplexity). Тож якщо ці боти приходять і післяDisallow, це ще не доводить, що правило не спрацювало. Як проаналізувати всі відвідування за період і звірити IP пакетно, описано в посібнику з аналізу логів AI-краулерів. - Звіряйте user-agent з офіційними IP-діапазонами, якщо провайдер їх публікує. Сам по собі user-agent легко підробити.
- Перевірте CDN (мережу доставки контенту) і WAF. Cloudflare, AWS WAF, nginx, плагіни безпеки чи інші плагіни WordPress можуть заблокувати бота ще до того, як він прочитає
robots.txt. - Врахуйте, що зміни діють не одразу. Станом на жовтень 2026 року OpenAI повідомляє, що на застосування змін для OAI-SearchBot може знадобитися близько 24 годин (документація OpenAI). В інших платформ терміни можуть бути інші.
Окремо перевірте, чи не заблокували ви випадково власні пріоритетні сторінки. Якщо після зміни правил з AI-відповідей зникають сторінки, які раніше цитувалися, причина може бути саме в доступі. У матеріалі які сторінки сайту найчастіше потрапляють у відповіді ШІ пояснено, як знайти такі сторінки й не закрити їх без потреби.
Типові помилки
Перевірте, чи не переплутали ви GPTBot з OAI-SearchBot, Googlebot з Google-Extended і основний домен із піддоменом. Disallow забороняє сумісному краулеру сканувати шлях, але сам по собі не видаляє URL з індексу. Шляхи, перелічені у відкритому robots.txt, може побачити будь-хто. RFC 9309 також пояснює, що краулери можуть кешувати файл, тобто якийсь час читати збережену копію. Нестандартну директиву Crawl-delay підтримують не всі.
robots.txt задає правила сканування, але не пояснює, чому сторінку варто цитувати. Для цього потрібні змістовний текст, зрозуміла структура та джерела. Про технічну розмітку читайте в матеріалі як структуровані дані впливають на AI-видимість.
Яку політику обрати для різних сайтів
Правила залежать від того, для чого ви відкриваєте сайт: для пошуку, для збору контенту на навчання чи для обох.
| Тип сайту | Практична політика |
|---|---|
| Блог або медіа | Пустити пошукових ботів, якщо хочете, щоб сторінки з'являлися у відповідях; окремо вирішити, чи дозволяти збір для навчання |
| SaaS або сервісний сайт | Відкрити сторінки продукту, блогу, FAQ, документації; закрити кабінети, тестові середовища, клієнтські розділи |
| E-commerce | Відкрити категорії, картки товарів, довідку; закрити кошик, пошук, фільтри з параметрами, особисті кабінети |
| B2B-компанія | Залишити доступними сторінки послуг, кейси, експертні матеріали; обережно поводитися з PDF, прайсами і клієнтськими матеріалами |
| Закрита база знань | Не покладатися на robots.txt; ставити авторизацію і серверний контроль доступу |
| Медичний, юридичний або фінансовий сайт | Узгодити політику з юристом чи фахівцем з відповідності вимогам, якщо для контенту діють обмеження |
Після зміни перевірте доступність robots.txt для кожного хоста, тестові відповіді сервера та журнали запитів.
Короткий алгоритм перевірки
Визначте, які системи мають знаходити сайт і чи дозволяєте ви використовувати його сторінки для навчання. Створіть окремі групи user-agent, перевірте файл для потрібного хоста і звірте тестові відповіді із серверними логами. Так ви керуєте AI-краулерами в robots.txt і не змішуєте пошук зі збором даних для навчання.
Часті запитання
Чи зникне сайт із ChatGPT, якщо заблокувати GPTBot? Ні, це окремі налаштування. OpenAI вказує, що OAI-SearchBot керує появою сайту в пошукових відповідях, а GPTBot пов'язаний зі збором даних для навчання. Перевірте обидві групи окремо.
Як заблокувати GPTBot через robots.txt?
Створіть групу User-agent: GPTBot і додайте Disallow: /, щоб попросити його не сканувати сайт. Залиште окреме правило для OAI-SearchBot, якщо хочете зберегти пошуковий доступ ChatGPT.
Чому бот усе ще приходить після Disallow?
Перевірте хост і групу user-agent, доступність /robots.txt та серверні логи. Perplexity зазначає, що запити Perplexity-User, які запускає сам користувач, зазвичай не підпорядковуються цьому файлу.
Як дозволити ChatGPT знаходити сайт?
Дозвольте OAI-SearchBot у robots.txt. Це дає змогу ChatGPT Search сканувати сторінки, але не гарантує, що конкретна сторінка з'явиться у відповіді.
Чим відрізняються GPTBot і OAI-SearchBot? GPTBot збирає сторінки, які можуть використати для навчання моделей. OAI-SearchBot сканує сторінки для пошукових відповідей ChatGPT. Документація OpenAI про краулери описує ці налаштування окремо.
Чи впливає Google-Extended на Google Search? Ні. Google зазначає, що Google-Extended не змінює включення сайту в Google Search і не є сигналом ранжування. Як зіставляються шляхи і чому важливий регістр, пояснює RFC 9309.
Як ми робимо це у VYDAI
GEO-аудит VYDAI перевіряє robots.txt для URL і надсилає тестові запити від імені ботів, зокрема OAI-SearchBot, Claude-SearchBot і PerplexityBot. Він також попереджає, якщо замість основного контенту сервер віддав щось схоже на сторінку WAF. Це перевірка доступу, а не моніторинг згадок бренду в Perplexity.
Для Google-Extended аудит читає правило у файлі, але не надсилає окремого HTTP-запиту, бо Google не використовує цей token як HTTP User-Agent. Тест VYDAI не доводить, що на сайт приходить офіційний краулер. Щоб це перевірити, звірте джерело запитів у серверних логах з офіційними IP-діапазонами. Відкрити GEO-аудит або зареєструватися у VYDAI.