Ось як перевірити доступність сторінки для AI-краулерів: звірте правила у файлі robots.txt, код HTTP-відповіді, текст у HTML-документі та правила захисту сайту. AI-краулер є автоматичною програмою, що завантажує сторінки для пошуку або обробки контенту. Браузер може показати потрібну сторінку, тоді як сервер віддає тестовому запиту повідомлення «перевірте, що ви людина». Перевіряйте саме потрібну URL-адресу, а не лише головну.
Рівні перевірки доступності
Доступність складається з кількох умов. Правило robots.txt описує політику обходу. Сервер і захист вирішують, яку відповідь віддати. Спосіб рендерингу визначає, чи є в цій відповіді потрібний текст. Директиви та індексація впливають на використання сторінки у конкретній пошуковій системі.
| Рівень | Питання | Чим перевірити |
|---|---|---|
| Політика обходу | Чи дозволений цей шлях потрібному боту? | robots.txt на відповідному хості |
| Отримання сторінки | Чи віддається потрібний документ без входу та перевірки браузера? | GET-запит, кінцева URL-адреса, код і тіло відповіді |
| Читання контенту | Чи є основний текст у отриманому документі? | Початковий HTML і порівняння з браузером |
| Пошукове використання | Чи дозволені індексація та потрібне прев’ю? | Meta robots, X-Robots-Tag, Search Console для Google |
Перевіряйте всі рівні для одного й того самого URL. Головна може бути доступною, а /pricing може бути закритою окремим правилом. Інший піддомен має свій robots.txt; правила для основного домену не описують автоматично весь ресурс.
Які краулери відповідають за пошук і навчання
Станом на жовтень 2026 року офіційні довідки провайдерів розрізняють пошукове сканування, отримання сторінки за запитом користувача й збирання матеріалів для навчання. Для доступу через Bing перевіряйте Bingbot: Microsoft пов’язує індексацію Bing із появою контенту у відповідях Copilot (Microsoft про сайти й Copilot, Bing Webmaster про AI Performance).
| Агент або токен | Призначення | Джерело правил |
|---|---|---|
| OAI-SearchBot | Пошук у ChatGPT | OpenAI |
| GPTBot | Збирання контенту, який може використовуватися для навчання | OpenAI |
| ChatGPT-User | Отримання сторінки за дією користувача | OpenAI |
| Claude-SearchBot | Пошук для Claude | Anthropic |
| ClaudeBot | Збирання контенту для можливого навчання | Anthropic |
| Claude-User | Отримання за запитом користувача | Anthropic |
| PerplexityBot | Пошукове виявлення сторінок | Perplexity |
| Perplexity-User | Отримання за запитом користувача | Perplexity |
| Googlebot | Google Search, включно з AI-функціями пошуку | Google Search Central |
| Google-Extended | Керування визначеними Google використаннями поза Search | Google про краулерів |
| Bingbot | Індексація Bing, що використовується в пошукових і Copilot-відповідях | Microsoft Learn |
Google-Extended є токеном керування в robots.txt, а не окремим HTTP User-Agent для тестового запиту. Для AI Overviews та AI Mode Google використовує правила Googlebot. Зміна Google-Extended не є способом увімкнути появу в цих пошукових функціях.
OpenAI розділяє налаштування пошуку й навчання. Станом на жовтень 2026 року OpenAI описує ChatGPT-User як агента для запитів користувачів, а Perplexity пояснює окрему поведінку Perplexity-User. Anthropic описує правила для своїх краулерів. Звіряйте поведінку кожного агента з довідкою його провайдера.
Крок 1. Перевірте публічний URL і кінцеву відповідь
Коди стану HTTP (протоколу передавання гіпертексту) визначає стандарт RFC 9110. Відкрийте сторінку без авторизації та зафіксуйте перенаправлення. Потім отримайте відповідь сервера GET-запитом, замінивши example.com/page на адресу потрібної сторінки.
curl -sS -L \
  -D page-headers.txt -o page.html \
  -w 'HTTP: %{http_code}\nURL: %{url_effective}\n' \
  'https://example.com/page'
-L переходить за перенаправленнями, -D зберігає заголовки, а -o зберігає тіло відповіді. У файлі заголовків можуть бути кілька відповідей; перевірте кінцеву. Команда з -I запитує HEAD і не дає тексту сторінки, тому для цієї задачі GET корисніший.
| Результат | Що перевірити |
|---|---|
| 200 із потрібним текстом | Перейти до правил і директив |
| 200 із перевіркою браузера або формою входу | Знайти причину підміни документа |
| 301/302 із правильною кінцевою сторінкою | Перевірити правила та контент саме кінцевої адреси |
| 401 | Чи є URL приватним або помилково захищеним |
| 403 | Правило сервера, CDN (мережі доставки контенту), WAF (мережевого екрана вебзастосунку) або мережеве обмеження |
| 404/410 | Чи існує URL і чи не видалено сторінку |
| 429 | Обмеження частоти, стан сервера та Retry-After |
| 5xx або таймаут | Помилка інфраструктури; перевірте час і повторюваність |
Код відповіді сам собою не встановлює причину. Будь-який незнайомий клієнт може отримати 403. Зафіксуйте час, URL і вміст відповіді, щоб адміністратор знайшов відповідну подію.
Крок 2. Перевірте правило robots.txt для потрібної сторінки
Щоб перевірити правило robots.txt для GPTBot на конкретному URL, знайдіть групу User-agent для цього агента й зіставте її правила з точним шляхом. Поле User-agent називає краулер, для якого діють наступні правила. Файл robots.txt розміщується в корені хоста, наприклад https://example.com/robots.txt. Загальні правила User-agent: * і правила агента застосовуються відповідно до RFC 9309.
Умовний приклад політики для обговорення з власником контенту: дозволити пошуковому агенту OpenAI публічні сторінки й закрити навчальний обхід. Не копіюйте приклад замість чинного файла без перевірки інших правил.
User-agent: OAI-SearchBot
Allow: /
Disallow: /account/
Disallow: /checkout/

User-agent: GPTBot
Disallow: /
Перевірте інші групи й закриті шляхи чинного файла. Рішення залежить від правил, що збігаються з агентом і адресою; одного Allow недостатньо. Параметри URL, регістр і кінцевий шлях після перенаправлення також можуть вплинути на результат.
robots.txt не захищає приватні дані. Google пояснює, що заблокована для обходу URL за певних умов усе ще може з’явитися в результатах пошуку без прочитаного вмісту (обмеження robots.txt у Google Search Central). Закривайте приватні документи авторизацією, а індексацію перевіряйте окремо.
Для ширшого набору прикладів є матеріал про керування AI-краулерами через robots.txt.
Як noindex і nosnippet впливають на AI-пошук
У HTML може бути <meta name="robots" content="noindex">, а заголовок може містити X-Robots-Tag: noindex. Для Google noindex забороняє індексацію. nosnippet обмежує текстовий фрагмент, data-nosnippet виключає вибрану частину сторінки з фрагмента, а max-snippet обмежує його довжину. Це описано в документації Google про директиви robots.
Швидка перевірка отриманих файлів:
rg -ni 'x-robots-tag|location:|content-type:' page-headers.txt
rg -ni 'noindex|nosnippet|max-snippet|data-nosnippet|canonical' page.html
Збіг пошуку ще потрібно прочитати в контексті: слово noindex може бути прикладом у тексті статті. Перевіряйте реальну директиву, її місце та застосовність до агента.
Щоб прочитати noindex, Google має отримати сторінку. Якщо одночасно закрити обхід через robots.txt, система може не побачити директиву. canonical вказує бажану версію дубльованого контенту, але не керує доступом.
Для AI Overviews та AI Mode Google вимагає індексації та придатності до показу зі сніпетом (правила участі в AI-функціях пошуку). Перевірте URL у Search Console: статус індексації, вибрану канонічну адресу й отриманий Google документ.
Як перевірити сторінку без JavaScript
Відкрийте page.html та знайдіть точну фразу з основного опису. JavaScript є мовою сценаріїв, яка може додавати вміст після завантаження сторінки. Перевірте заголовок, характеристики, умови та посилання. Якщо є лише <div id="root"></div> і скрипти, основний зміст може з’являтися лише після виконання JavaScript.
Googlebot може рендерити JavaScript, але це відбувається в окремому етапі обробки. Інші краулери можуть мати інші можливості. Серверний рендеринг або попередньо сформований HTML віддає основний текст у початковій відповіді (пояснення Google про JavaScript SEO).
Умовний критерій для розробника: у початковій відповіді є H1, опис послуги, ціна або її умови й основні посилання. Після зміни порівняйте HTML із видимою сторінкою: вони мають описувати той самий продукт. Не створюйте окремий рекламний текст лише для ботів.
Якщо важливі умови сховані в зображенні або інтерактивному віджеті, продублюйте їх текстом у початковій відповіді.
Як перевірити сторінку через curl із User-Agent GPTBot
Команда curl із заголовком User-Agent показує, як сервер відповідає тестовому запиту. Вона не доводить, що провайдер може отримати сторінку зі своєї мережі.
curl -sS -L \
  -A 'GPTBot' \
  -D bot-headers.txt -o bot-page.html \
  -w 'HTTP: %{http_code}\nURL: %{url_effective}\n' \
  'https://example.com/page'
Зіставте кінцеву адресу, статус і вміст звичайної відповіді та проби GPTBot. Якщо одна з них отримала 403, перевірте журнали захисту. Навіть успішний код відповіді не замінює перевірки вмісту.
Як перевірити справжнього AI-краулера за логами сервера
Щоб перевірити справжнього AI-краулера за логами сервера, зіставте User-Agent, час і URL із перевіркою IP чи DNS, яку описує провайдер. Станом на 3 жовтня 2026 року IP-списки публікують OpenAI, Anthropic, Perplexity, Apple, Mistral, DuckDuckGo та Bing; Google публікує діапазони й описує reverse та forward DNS-перевірку у довідці з верифікації Googlebot. Документація Meta про краулерів не містить опублікованого IP-списку. Рядок User-Agent можна підмінити.
Щоб перевірити всі відвідування за період і пакетно звірити IP, скористайтеся посібником з аналізу логів AI-краулерів.
Що робити, якщо Cloudflare блокує AI-ботів
Знайдіть подію за часом тесту й точним шляхом. Перевірте, чи спрацювали перевірка браузера, IP-фільтр, автоматичний захист, географічне обмеження або ліміт частоти. З’ясуйте, чи зачепило правило весь сайт або лише окремий маршрут.
Станом на жовтень 2026 року Cloudflare пропонує AI Crawl Control для перегляду активності краулерів і керування правилами доступу. Параметр Managed robots.txt змінює файл, який Cloudflare віддає на сайті. AI Crawl Control може застосовувати блокування через правило WAF, тому перевірте і файл, і подію безпеки (керування краулерами в AI Crawl Control, Managed robots.txt у Cloudflare).
Якщо політика бізнесу дозволяє пошуковому краулеру доступ, попросіть адміністратора налаштувати вузький виняток для підтвердженої мережевої адреси й потрібних публічних шляхів. Не вимикайте захист сайту через один тестовий запит.
Після погодженої зміни перевірте журнали та повторіть запит. Помилка 403 для AI-краулера може стосуватися конкретного агента або всіх незнайомих клієнтів, тож зіставте звичайний запит, пробу й подію захисту. Для HTTP 429 перевірте ліміт частоти та стан сервера.
Як розібрати результати перевірки
| Симптом | Що перевірити першим | Яке виправлення перевіряти |
|---|---|---|
| У браузері є текст, у HTML його немає | Початкову відповідь і відображену сторінку | Розмістити потрібний текст у серверній відповіді |
| robots.txt дозволяє, але запит отримує 403 | Правило для шляху, журнал CDN/WAF і User-Agent | З’ясувати, чи блокується конкретний агент або незнайомі клієнти |
| Статус 200, але вмістом є перевірка браузера | Тіло відповіді та подію захисту | Попросити адміністратора перевірити умову, що повертає перевірку |
| Частина адрес доступна, частина ні | Шлях, піддомен і кінцеву адресу після перенаправлення | Повторити перевірку для URL з того самого шаблону |
| Після перенаправлення відкривається інша мова | Кінцеву адресу, файли cookie та географічне правило | Перевірити потрібну мовну версію окремо |
| Google не індексує сторінку | URL Inspection, noindex і canonical | Виправляти причину, яку показує Search Console |
| AI не згадує бренд, хоча сторінка доступна | Запит, відповідь і джерела | Перевірити зміст і згадки бренду окремо від доступу |
| Відповідь має статус 429 | Ліміт частоти й стан сервера | Перевірити обмеження та повторити запит після погодженої зміни |
Для повнішої перевірки сторінки скористайтеся чеклістом GEO-аудиту. Якщо сторінка доступна, але її не цитують, перевірте які типи сторінок найчастіше з’являються у відповідях ШІ. Якщо ж бренд узагалі відсутній у відповідях, дивіться можливі причини відсутності бренду в ChatGPT, Gemini чи Claude.
Критерії приймання виправлення
Зафіксуйте докази до й після зміни:
- URL, час і тип запиту.
- Кінцеву адресу, HTTP-статус і фрагмент отриманого документа.
- Правило robots.txt для агента й шляху.
- Meta robots і X-Robots-Tag у відповіді.
- Запис у журналі про підтверджений краулер, якщо саме його доступ перевіряли.
- Результати для інших сторінок цього шаблону.
Перевіряйте індексацію в інструменті відповідної пошукової системи. Успішний запит не доводить, що бренд з’явиться у відповіді ChatGPT: на це також впливають зміст сторінки, запит і доступні джерела.
Після зміни правила або відповіді сервера перевірте доступність сторінки для AI-краулерів повторно тим самим URL і порівняйте отриманий документ.
Джерела й метод перевірки
Приклади curl і robots.txt у статті є умовними. Замініть example.com на власний публічний URL і перевірте отриманий документ та журнали свого сайту.
- OpenAI про призначення та керування краулерами.
- Anthropic про краулери Claude і правила доступу.
- Perplexity про краулери й перевірку запитів.
- RFC 9309 про протокол robots.txt.
- RFC 9110 про семантику HTTP-відповідей.
- Google про robots.txt та його обмеження.
- Google про директиви robots.
- Google про JavaScript SEO.
- Google про вимоги до AI-функцій пошуку.
- Cloudflare про керування AI-краулерами.
- Cloudflare про керований robots.txt.
- Microsoft про сайти, Bingbot і Copilot.
Часті запитання
Як перевірити доступ GPTBot до сайту? Зробіть звичайний GET-запит і окрему пробу з User-Agent GPTBot для тієї самої сторінки. Порівняйте адресу, статус і вміст; реальне звернення GPTBot підтверджуйте за журналами й IP-діапазонами з довідки OpenAI про краулери.
Чи бачить ChatGPT мій сайт? Перевірте доступ OAI-SearchBot, відповідь сервера й основний текст у HTML. Це покаже, чи бачить ChatGPT мій сайт технічно, але не доводить, що він використає сторінку у відповіді.
Як перевірити доступ OAI-SearchBot до сторінки? Перевірте правило robots.txt для точного шляху, а потім порівняйте звичайний GET із пробою, у якій задано User-Agent OAI-SearchBot. Сама проба не підтверджує запит із мережі OpenAI.
Що робити, якщо Cloudflare блокує AI-ботів? Знайдіть подію за URL і часом, перевірте налаштування AI Crawl Control, керований robots.txt і правило WAF. Попросіть адміністратора змінити лише ту політику, яка відповідає рішенню власника сайту, а потім повторіть перевірку.
Що перевірити, якщо виникла помилка 403 для AI-краулера? Зіставте відповідь звичайного запиту, User-Agent проби й журнал захисту. Якщо 403 отримують також інші незнайомі клієнти, причина може бути загальним правилом CDN або WAF.
Як перевірити справжнього AI-краулера за логами сервера? Знайдіть у журналі URL і час звернення, а потім перевірте IP чи DNS способом, який публікує відповідний провайдер. User-Agent сам по собі можна підробити.
Як ми робимо це у VYDAI
У публічному аудиті видимості в генеративному пошуку (GEO) VYDAI перевірте блок доступності: він показує правила robots.txt для сторінки та відповіді тестових запитів. Ці дані допомагають передати адміністратору конкретний шлях або відповідь сервера для перевірки.
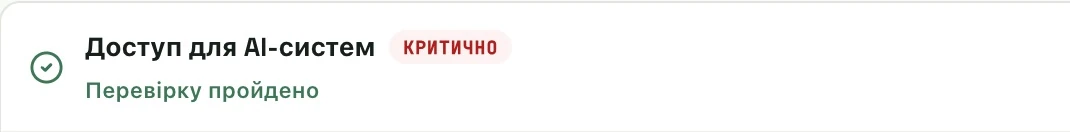
На зображенні «Критично» є загальним вердиктом звіту, а «Перевірку пройдено» стосується лише цього критерію.
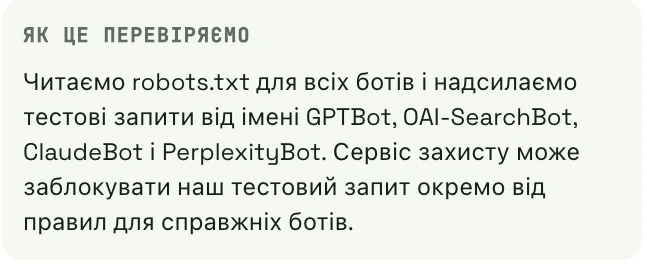
Аудит надсилає тестові запити з назвами ботів. Їхні результати не доводять, що справжній краулер провайдера може зайти з його мережі. У зображенні показаний технічний User-Agent тест, а не моніторинг згадок Perplexity. Перегляньте також пояснення статусів GEO-звіту.
Окремо моніторинг видимості VYDAI показує бренд у ChatGPT, Gemini, Claude, Google AI Overviews і Google AI Mode. Для доступу до цих звітів перейдіть до демо VYDAI. Ручних команд і серверних журналів достатньо для одноразової перевірки однієї сторінки.
Як перевірити доступність сторінки для AI-краулерів після зміни robots.txt або WAF? Повторіть запит до того самого URL і збережіть відповідь сервера та запис у журналі.