Щоб перевірити відвідування сайту AI-ботами, завантажте access log за потрібний період, відфільтруйте запити за User-Agent (рядком, яким бот себе називає), а тоді згрупуйте їх за ботом, URL, кодом відповіді й датою. IP-адреси звірте з офіційними списками компаній або перевірте через DNS, якщо це вимагає документація. Так ви побачите, хто звертався до сервера і які сторінки просив. Лог підтверджує лише запит до конкретного рівня інфраструктури. Він не показує, чи процитував AI сторінку у відповіді.
Як перевірити відвідування сайту AI-ботами: порядок дій
- Виберіть період, наприклад останні 7 або 30 днів, і збережіть копію access log.
- Знайдіть рядки з User-Agent відомих AI-ботів та окремо порахуйте кожну назву.
- Згрупуйте рядки за URL, статусом і днем, щоб побачити сторінки та зміни у часі.
- Звірте IP-адреси з опублікованими діапазонами; для Google й Apple виконайте описану ними DNS-перевірку.
- Визначте роль кожного агента: пошук, тренувальний збір чи отримання сторінки на дію користувача.
- Зіставте лог із журналом CDN, якщо запити проходять через кеш або проксі.
- Перевірте висновки на рівні відповідей окремо, якщо потрібно знати, чи згадує AI бренд або цитує сторінку.
Де знайти логи сервера сайту
Як перевірити логи AI-ботів, залежить від того, де їх записує ваш хостинг. Знайдіть access log і з'ясуйте його формат, часовий пояс та строк зберігання. Якщо доступу до файла немає, попросіть адміністратора експортувати сирі рядки журналу.
| Тип хостингу | Де шукати | На що зважити |
|---|---|---|
| VPS з Apache | Каталог журналів вебсервера, типовий шлях задає конфігурація віртуального хоста | Фактичний шлях і формат можуть відрізнятися від стандартного |
| VPS з Nginx | Файл, заданий директивами access_log у конфігурації сервера | Адміністратор міг налаштувати власні поля |
| cPanel | Розділ Raw Access або завантаження журналів домену | Перевірте, чи включені архіви попередніх періодів |
| Plesk | Журнали домену в панелі або файли в каталозі підписки | Назви пунктів залежать від версії та прав користувача |
| Керований або shared hosting | Запит до підтримки хостингу на експорт сирих access logs | Уточніть період, часовий пояс, ротацію і поля |
| Cloudflare чи інший CDN | Журнал на edge-рівні; у Cloudflare також є AI Crawl Control і Logpush | Доступні поля та спосіб експорту залежать від конфігурації й тарифу |
| Vercel або Netlify | Журнали запитів у панелі проєкту або доступний експорт платформи | Перевірте строк зберігання та охоплення edge-запитів у вашому плані |
| WordPress-плагін | Звіт плагіна, якщо він записує звернення на рівні застосунку | Плагін може не бачити відповіді з кешу чи CDN, які оминули PHP |
Кешований запит іноді завершується на CDN, не доходячи до origin-сервера. Так само заблокований запит може бути видимий на edge, але відсутній у журналі origin. Тому порівнюйте обидва рівні. У Cloudflare AI Crawl Control показує активність AI-краулерів; для сирих полів запитів є Logpush і Logpull. Доступ до цих журналів і доступні поля залежать від плану Cloudflare.
Як читати рядок логу
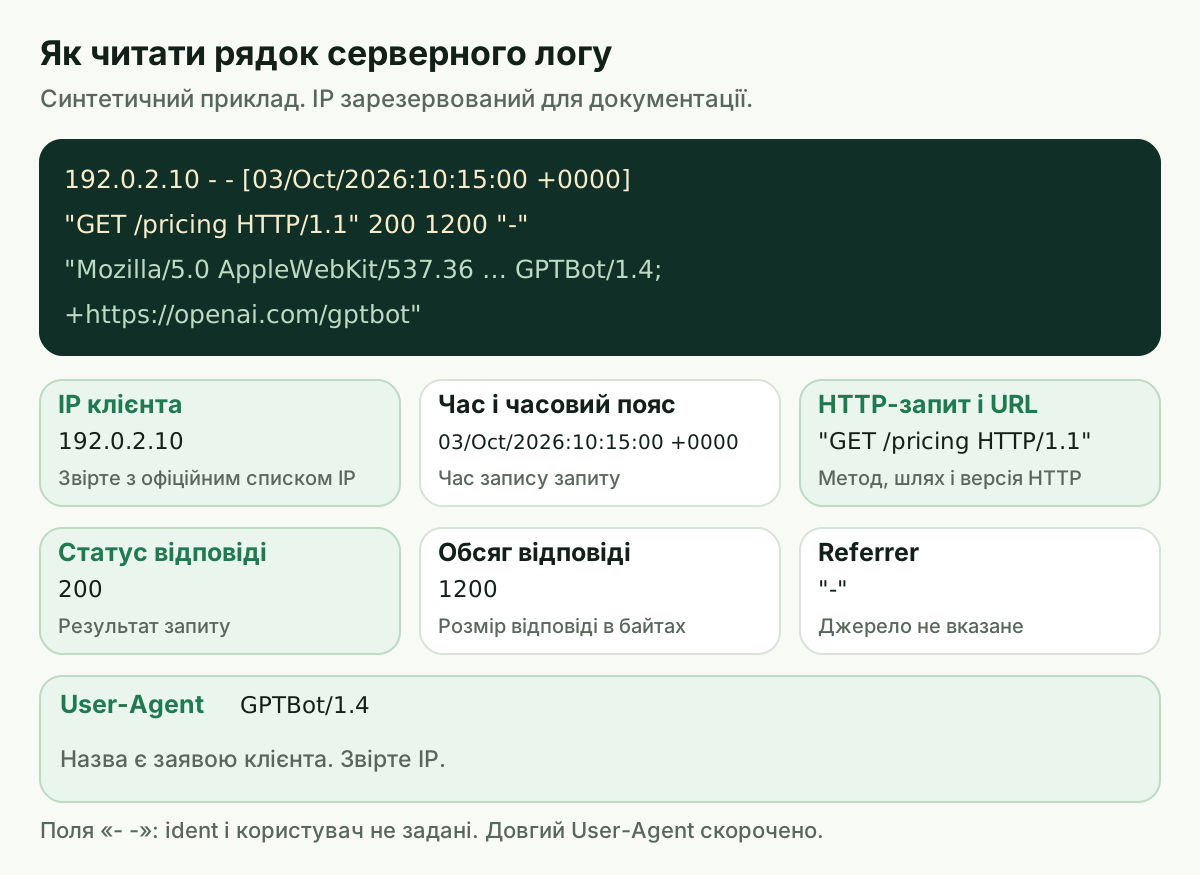
У combined format Apache та Nginx адреса клієнта, час, HTTP-запит, статус, обсяг відповіді, referrer і User-Agent стоять у передбачуваних місцях. Наприклад, такий рядок є синтетичним і використовує зарезервовану для документації IP-адресу:
192.0.2.10 - - [03/Oct/2026:10:15:00 +0000] "GET /pricing HTTP/1.1" 200 1200 "-" "Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko); compatible; GPTBot/1.4; +https://openai.com/gptbot"
У цьому рядку 192.0.2.10 позначає адресу клієнта, квадратні дужки містять час, GET /pricing показує метод і шлях, 200 показує код відповіді, а останній фрагмент містить User-Agent. Combined format Apache описує документація mod_log_config; у Nginx поля задаються конфігурацією і можуть відрізнятися. JSON-журнал, проксі або власна схема також змінюють їхній порядок.
Які AI-боти з’являються в логах і що вони роблять
Назва в User-Agent допомагає класифікувати запит, але спочатку є лише заявою клієнта. Призначення звіряйте з довідкою власника агента. Найзручніше читати логи AI-краулерів за роллю, а політику обходу налаштовувати окремо за правилами robots.txt для AI-ботів.
| Агент у User-Agent | Компанія і роль | Що важливо для читання логу |
|---|---|---|
GPTBot | OpenAI, збір вебсторінок, які можуть використовуватися для навчання моделей | Не є агентом пошуку ChatGPT; OpenAI публікує окремий список IP |
OAI-SearchBot | OpenAI, пошукові можливості ChatGPT | Відокремлюйте від GPTBot і від отримання сторінки на дію користувача |
ChatGPT-User | OpenAI, запит сторінки за дією користувача | Це не автоматичний обхід; правила robots.txt можуть не застосовуватись |
OAI-AdsBot | OpenAI, перевірка цільових сторінок оголошень | Не зараховуйте ці звернення до пошукового обходу |
ClaudeBot | Anthropic, збір контенту для моделей | Anthropic вказує, що дотримується robots.txt |
Claude-SearchBot | Anthropic, пошукові можливості Claude | Окрема роль від навчального збору |
Claude-User | Anthropic, запит сторінки за зверненням користувача | Розглядайте як fetch, а не як загальний обхід |
PerplexityBot | Perplexity, індексування для пошуку | Компанія відрізняє його від навчального збору моделей |
Perplexity-User | Perplexity, сторінка за дією користувача | У документації сказано, що він зазвичай ігнорує robots.txt |
Googlebot | Google Search, зокрема AI Overviews та AI Mode | Окремого User-Agent для цих AI-функцій немає; працює звичайна пошукова інфраструктура |
Google-CloudVertexBot, GoogleOther | Google, інші задокументовані агенти для хмарних продуктів або досліджень | Перевіряйте конкретне призначення в актуальному довіднику Google |
Google-Extended | Токен керування у robots.txt | Це не User-Agent запиту, тому шукати його в логах марно |
Applebot | Apple, індексування для пошукових функцій Apple | Перевіряйте IP через опублікований список або DNS-метод Apple |
Applebot-Extended | Токен керування використанням контенту | Не є окремим User-Agent і не з’явиться як агент у рядку запиту |
Amazonbot, Amzn-SearchBot, Amzn-User | Amazon, збір, пошукова індексація та отримання сторінки на запит користувача | У компанії окремі описи та діапазони для різних ролей |
Meta-ExternalAgent, Meta-WebIndexer, Meta-ExternalFetcher | Meta, збір, індексування та отримання сторінки за дією користувача | Довідка Meta описує агентів, але не публікує IP-список |
MistralAI-Index, MistralAI-Training, MistralAI-User | Mistral, пошуковий індекс, тренувальний збір і користувацьке отримання | Роль залежить від назви; доступність IP-списку також різниться |
DuckAssistBot | DuckDuckGo, актуальне сканування для AI-підтриманих відповідей | Компанія публікує окремий список адрес |
CCBot | Common Crawl, збір відкритого вебархіву, який можуть використовувати дослідники й розробники AI (FAQ Common Crawl) | Запит не вказує, яка саме модель або відповідь використає архів |
bingbot | Microsoft Bing, пошуковий індекс, що може живити відповіді Copilot | Зіставляйте з опублікованим списком Bing, а не лише з назвою агента |
Довідка OpenAI про ботів, Anthropic про вебкраулерів та документація Perplexity описують різні типи запитів та їхню поведінку щодо правил обходу. Серед основних ролей є пошукова індексація, збір для можливого навчання та отримання URL через дію людини. Якщо змішати їх в одну цифру «AI-боти», графік не скаже, що саме змінилося.
Google-Extended і Applebot-Extended є токенами для правил, а не агентами, що надсилають HTTP-запит. AI Overviews і AI Mode використовують звичайну пошукову систему та Googlebot, як пояснено в описі AI-функцій Google Search.
Як знайти AI-ботів у логах сервера
Нижче наведені команди для стандартного combined access log у поточному каталозі. Вони підраховують назви з User-Agent, тобто твердження клієнтів, а не підтверджені компанії. Після фільтрації переходьте до перевірки IP.
| Питання | Команда для combined log |
|---|---|
| Знайти рядки GPTBot у логу | grep -i 'GPTBot' access.log |
| Порахувати рядки GPTBot | grep -ic 'GPTBot' access.log |
| Згрупувати URL GPTBot | awk -F'"' '$6 ~ /GPTBot/ { split($2, req, " "); count[req[2]]++ } END { for (url in count) print count[url], url }' access.log |
| Порахувати статуси GPTBot | awk '$9 ~ /^[0-9][0-9][0-9]$/ && /GPTBot/ { count[$9]++ } END { for (status in count) print status, count[status] }' access.log |
| Знайти robots.txt і llms.txt | grep -F '/robots.txt' access.log; grep -F '/llms.txt' access.log |
| Порахувати GPTBot за днями | awk -F'[][]' '/GPTBot/ { day=substr($2,1,11); count[day]++ } END { for (day in count) print day, count[day] }' access.log |
| Переглянути gzip-ротації | zgrep -Ei 'GPTBot' access.log*.gz |
Команди в таблиці дають компактний зріз за GPTBot. Нижче є варіанти з кількома назвами агентів для повнішого відбору.
Як знайти GPTBot у логах сервера
У combined форматі User-Agent стоїть після попередніх полів і зазвичай є останньою quoted-частиною рядка. Простий фільтр знаходить рядки, у яких зустрічається назва. Пошук допомагає знайти згадки, але не підтверджує джерело: будь-який клієнт може самостійно надіслати цей текст.
grep -i 'GPTBot' access.log
Щоб зберегти звернення відомих агентів для подальшого аналізу, відфільтруйте їх за User-Agent. У виразі враховані окремі ролі OpenAI, Anthropic і Perplexity, а також інші назви з таблиці ботів. Команда шукає заявлені назви, не підтверджені IP. Токени Google-Extended та Applebot-Extended не додавайте: це не назви HTTP-клієнтів у User-Agent.
grep -Ei 'GPTBot|OAI-SearchBot|ChatGPT-User|OAI-AdsBot|ClaudeBot|Claude-SearchBot|Claude-User|PerplexityBot|Perplexity-User|Googlebot|Google-CloudVertexBot|GoogleOther|Applebot|Amazonbot|Amzn-SearchBot|Amzn-User|Meta-ExternalAgent|Meta-WebIndexer|Meta-ExternalFetcher|MistralAI-[[:alnum:]-]*|DuckAssistBot|CCBot|bingbot' access.log > ai-bots.log
Як порахувати запити GPTBot по днях
Дата у прикладі нижче береться з формату [dd/Mon/yyyy:hh:mm:ss]. Часовий пояс залишається в самому timestamp, але групування відкидає годину. За потреби переведіть час у часовий пояс сайту до порівняння з релізами чи змінами конфігурації.
grep -i 'GPTBot' access.log | awk -F'[][]' '{print substr($2,1,11)}' | sort | uniq -c
Лічильник рахує рядки з назвами, а не унікальні IP чи успішно віддані сторінки. Якщо в одному User-Agent зазначено два імені ботів, команда зарахує цей рядок двічі.
grep -Eio 'GPTBot|OAI-SearchBot|ChatGPT-User|ClaudeBot|Claude-SearchBot|Claude-User|PerplexityBot|Perplexity-User|Googlebot|Applebot|Amazonbot|Meta-ExternalAgent|CCBot|bingbot' access.log | sort | uniq -c | sort -nr
Які сторінки відвідують AI-боти
У combined форматі HTTP-запит знаходиться між лапками. Наступна команда дістає друге поле з цієї частини, тобто шлях після методу. Вона показує кількість рядків для GPTBot по URL; query string, якщо він є, залишиться частиною адреси.
grep -i 'GPTBot' access.log | awk -F'"' '{print $2}' | awk '{print $2}' | sort | uniq -c | sort -nr | head -20
Відсортуйте повний звіт також за датою, якщо треба розібрати конкретний сплеск. Для багатьох форматів логу зручніше імпортувати файл у парсер, який розуміє схему полів, а не будувати новий набір awk для кожного варіанта.
Статуси відповідей для AI-ботів
У стандартному whitespace-представленні combined рядка код відповіді є дев'ятим полем. Ця позиція підходить лише для такого формату і цієї конфігурації.
grep -i 'GPTBot' access.log | awk '{print $9}' | sort | uniq -c | sort -nr
Статус допомагає знайти групу для перевірки: 200 означає успішну HTTP-відповідь, але не підтверджує корисний вміст; 301 або 302 означає перенаправлення; 304 означає, що клієнт може використати кешовану копію; 403 і 429 показують відмову чи обмеження; серія 5xx вказує на серверні помилки. Перевірте, куди веде перенаправлення і яке тіло повернулося, перш ніж робити висновок про доступність.
Запити до robots.txt і llms.txt
Службові файли зручно виділити окремо. Фільтр враховує GET і HEAD та можливі query-параметри. Наявність рядка показує звернення до URL, але сама собою не підтверджує, як клієнт обробив файл.
grep -Ei '"(GET|HEAD) /(robots\.txt|llms\.txt)([? ]|$)' access.log | awk -F'"' '{print $1 " " $2 " " $3}'
Перевірка в цій секції відповідає на питання «що є у файлі журналу». Якщо треба з'ясувати, чи дозволено конкретній адресі сканувати певну сторінку, це інша перевірка. Про призначення llms.txt і правила обходу читайте окремо.
Для ротацій, стиснених gzip, команда zgrep шукає в архівах за тією ж логікою:
zgrep -Ei 'GPTBot|OAI-SearchBot|ChatGPT-User|ClaudeBot|Claude-SearchBot|Claude-User|PerplexityBot|Perplexity-User' access.log*.gz
Спершу перевірте маску назв файлів у вашому хостингу. Архіви часто охоплюють попередні дні, тож аналіз лише поточного access.log може обрізати період і спотворити тренд.
Як перевірити IP-адресу GPTBot та інших AI-ботів
Не покладайтеся на User-Agent як на підтвердження особи: його легко скопіювати. Витягніть унікальні адреси для кожного агента, порівняйте їх із поточним списком компанії, а результат позначте як «підтверджено», «не підтверджено» або «список не публікується». Непідтверджена адреса сама по собі ще не доводить зловмисну активність.
| Компанія | Де перевірити IP | Що робити з результатом |
|---|---|---|
| OpenAI | https://openai.com/gptbot.json; https://openai.com/searchbot.json; https://openai.com/chatgpt-user.json; https://openai.com/adsbot.json | Кожен файл містить creationTime та prefixes з ipv4Prefix і, якщо є, ipv6Prefix |
| Anthropic | https://claude.com/crawling/bots.json | JSON має creationTime і масив prefixes з ipv4Prefix |
| Perplexity | https://www.perplexity.com/perplexitybot.json; https://www.perplexity.com/perplexity-user.json | JSON має creationTime і масив prefixes з ipv4Prefix |
| Google, автоматичні краулери | https://developers.google.com/static/crawling/ipranges/common-crawlers.json | prefixes містить ipv4Prefix та ipv6Prefix; звіряйте потрібну адресу з цим списком |
| Google, запити на дію користувача | https://developers.google.com/static/crawling/ipranges/user-triggered-fetchers.json; https://developers.google.com/static/crawling/ipranges/user-triggered-fetchers-google.json; https://developers.google.com/static/crawling/ipranges/user-triggered-agents.json | Це окремі списки fetcher-ів; не перевіряйте user-triggered агент лише за common crawlers |
| Apple | https://search.developer.apple.com/applebot.json | JSON має creationTime і prefixes з ipv4Prefix; документація також описує reverse та forward DNS |
| Amazon | https://developer.amazon.com/amazonbot/ip-addresses/; https://developer.amazon.com/amazonbot/searchbot-ip-addresses/; https://developer.amazon.com/amazonbot/live-ip-addresses/ | Це HTML-сторінки, у тексті яких є JSON із prefixes; скопіюйте його в окремий файл перед перевіркою. Окремі значення ipv4Prefix записані як одинична IP без маски |
| Meta | Офіційна довідка Meta не публікує список IP для цих агентів | Позначте «список не публікується»; одного збігу User-Agent недостатньо |
| Mistral | https://mistral.ai/mistralai-user-ips.json; https://mistral.ai/mistralai-index-ips.json | Обидва JSON мають creationTime і prefixes з ipv4Prefix; перевіреного списку для MistralAI-Training немає |
| DuckDuckGo | https://duckduckgo.com/duckassistbot.json | JSON має creationTime та масив prefixes з ipv4Prefix |
| Microsoft Bing | https://www.bing.com/toolbox/bingbot.json | Перевіряйте IP за опублікованим JSON, а не лише за User-Agent |
| Common Crawl | Для CCBot окремий список IP не вказаний у FAQ Common Crawl | Позначте «список не публікується» |
У перевірених JSON-списках постачальники використовують масив prefixes, де ключ може називатися ipv4Prefix або ipv6Prefix. Скрипт нижче приймає обидва ключі; ipaddress також читає одиничну адресу без CIDR-маски. Файли й схеми можуть змінитися, тому перед регулярним запуском звіряйте їх зі сторінкою постачальника.
Спершу збережіть унікальні адреси з рядків одного агента:
grep -i 'GPTBot' access.log | awk '{print $1}' | sort -u > gptbot-ips.txt
Збережіть наступний скрипт як verify_ips.py. Він читає файл IP-адрес першим аргументом, JSON зі списком префіксів другим і друкує статус для кожної адреси:
import ipaddress
import json
import sys

if len(sys.argv) != 3:
    raise SystemExit("Usage: python3 verify_ips.py IP_FILE RANGES_JSON")
with open(sys.argv[1], encoding="utf-8") as f:
    addresses = [line.strip() for line in f if line.strip()]
with open(sys.argv[2], encoding="utf-8") as f:
    data = json.load(f)
networks = []
for item in data.get("prefixes", []):
    for key in ("ipv4Prefix", "ipv6Prefix"):
        if key in item:
            networks.append(ipaddress.ip_network(item[key], strict=False))
if not networks:
    raise SystemExit("No prefixes found in the JSON file")
for address in addresses:
    ip = ipaddress.ip_address(address)
    result = "verified" if any(ip in network for network in networks) else "not in list"
    print(f"{ip}: {result}")
Наприклад, передайте відповідні файли командою python3 verify_ips.py gptbot-ips.txt openai-gptbot.json. Це стартовий варіант для JSON із prefixes, а не універсальний валідатор будь-якого майбутнього формату.
Для Google та Apple перевірте reverse DNS, а потім прямим запитом переконайтеся, що hostname повертає ту саму IP. У першій команді задайте адресу з логу; у другій підставте hostname з PTR-відповіді:
dig +short -x "$ip"
dig +short "<hostname-from-ptr>"
Для Google звірте hostname з офіційним доменом відповідного типу агента, для Apple він має завершуватися на .applebot.apple.com. Forward lookup має повернути початкову IP. Перевірка лише PTR недостатня.
Google описує порядок перевірки IP у документації про верифікацію запитів. Для пакетного аналізу перевіряйте унікальні IP, а не кожен повторний рядок.
Якщо сайт стоїть за проксі, адресу в origin-лозі може займати сам CDN. Не довіряйте довільному X-Forwarded-For: приймайте його лише від відомого довіреного проксі, налаштованого сервером. Для одного підозрілого запиту й перевірки доступу до окремої сторінки є окремий посібник з перевірки AI-краулерів.
Що означають запити ChatGPT-User у логах
ChatGPT-User позначає отримання сторінки за дією людини в ChatGPT, а не регулярний обхід усього сайту. Таку саму роль мають Claude-User, Perplexity-User, Meta-ExternalFetcher, MistralAI-User та Amzn-User. Деталі правил різняться: OpenAI попереджає, що robots.txt може не застосовуватися до ChatGPT-User, Perplexity каже, що Perplexity-User зазвичай ігнорує ці правила, а Anthropic заявляє, що її агенти їх дотримуються. У документації Meta вказано, що Meta-ExternalFetcher може обходити robots.txt; Amazon уточнює, що Amzn-User може не виконувати всі його директиви у своїй довідці про Amazonbot.
Такий рядок підтримує обмежений висновок: у зафіксований час агент отримав або спробував отримати конкретний URL через дію в інтерфейсі. Він не розкриває автора запиту, текст запитання чи те, чи потрапила сторінка до фінальної відповіді. У мережі Cloudflare сканування за дією користувача зросло більш ніж у 15 разів у 2025 році; Cloudflare пов'язує цю динаміку з трафіком ChatGPT-User. Це мережеве спостереження за рік, а не норма для окремого сайту, як зазначено в огляді Cloudflare Radar за 2025 рік. Для власного домену перевірте частоту таких звернень і статуси запитаних сторінок.
Як часто AI-боти відвідують сайт
Єдиної норми для кількості відвідувань немає. Частота залежить від розміру й оновлення сайту, ролі бота, доступності сторінок, карти сайту, обмежень частоти та точки, де пишеться лог. Спочатку зберіть власну базову лінію по тижнях; порівнюйте однакові дні тижня й однаковий набір хостів.
Як аналізувати логи AI-краулерів у динаміці
Для тижневого порівняння спершу виведіть день і назву агента для кожного рядка, а потім згрупуйте однакові пари:
awk -F'"' '{ ua=$6; if (match(ua, /GPTBot|OAI-SearchBot|OAI-AdsBot|ChatGPT-User|ClaudeBot|Claude-SearchBot|Claude-User|PerplexityBot|Perplexity-User|Googlebot|Google-CloudVertexBot|GoogleOther|Applebot|Amazonbot|Amzn-SearchBot|Amzn-User|Meta-ExternalAgent|Meta-WebIndexer|Meta-ExternalFetcher|MistralAI-(User|Index|Training)|DuckAssistBot|CCBot|bingbot/)) { bot=substr(ua,RSTART,RLENGTH); day=substr($1,index($1,"[")+1,11); print day, bot } }' access.log | sort | uniq -c
Результат має денний зріз у часовому поясі запису логу. Щоб зіставити тижні, агрегуйте дні за ISO-тижнем з урахуванням року, а не просто складіть однакові номери тижня за різні роки.
Практичний спосіб аналізувати логи AI-краулерів полягає у порівнянні однакових днів тижня та ролей ботів. Так легше відрізнити нові сторінки в обході від звичайних повторних запитів.
| Метрика | Як порахувати | Що показує |
|---|---|---|
| Запити за роллю за тиждень | У згрупованому виводі складіть денні рядки для ботів однієї ролі та ISO-тижня | Зміни частоти пошукового, тренувального й користувацького отримання |
| Унікальні URL за ботом | Відкиньте дублікати шляхів окремо для кожного User-Agent у межах тижня | Наскільки широким є обхід сторінок, незалежно від повторних запитів |
| Частка не-200 відповідей за ботом | кількість статусів не 200 / усі запити бота × 100% за тиждень | Частоту перенаправлень, відмов, обмежень та помилок сервера |
| URL, запитані вперше | Порівняйте множину URL тижня з усіма URL у попередніх логах | Нові сторінки у видимому для вас обході |
| URL із запитами user-fetch агентів | Відфільтруйте ChatGPT-User, Claude-User і Perplexity-User, а тоді зберіть унікальні шляхи | Які сторінки отримували на дію користувачів |
Таблиця допомагає побачити власні зміни: наприклад, нові URL почали отримувати пошукові запити або після зміни правил зросла частка відмов. У огляді Cloudflare Radar за 2025 рік наведено частки HTML-запитів у мережі Cloudflare: інші AI-боти без Googlebot становили в середньому 4,2%, сам Googlebot 4,5%. Це мережеві середні за 2025 рік, а не прогноз чи норма для окремого сайту.
Для порівняння фіксуйте часовий пояс і домен. Сплеск на edge без змін в origin може бути наслідком кешу або блокування до сервера. Після змін sitemap чи robots.txt занотуйте дату. Частоту відвідувань оцінюйте відносно власної базової лінії, а не за числом іншого домену.
Що логи показують, а чого ні
Один рядок має значення лише разом із перевіркою джерела, URL, статусу та рівня журналу. Таблиця допомагає вибрати наступну перевірку, не роблячи висновок ширшим за наявні дані.
| Що бачите | Що це підтверджує | Чого не доводить | Що перевірити далі |
|---|---|---|---|
Підтверджений OAI-SearchBot отримав сторінку зі статусом 200 | Запит цього агента дійшов до журналу і сервер відповів успішно | Що сторінка потрапила до індексу або відповіді ChatGPT | Перевірте URL, тіло відповіді та видимість у відповідях окремо |
ChatGPT-User запитав один URL | Сторінку запросили під час дії в ChatGPT | Що її процитували або який саме промпт її викликав | Перевірте, чи з'являється цей URL серед цитованих джерел для пов'язаних запитів у моніторингу відповідей, і чи повернув сервер статус 200 з повним вмістом |
| GPTBot має 403 або 429 | Для цього запиту сервер чи захист відмовив або застосував обмеження | Що це обов'язково помилка конфігурації або що всі інші агенти заблоковані | Зіставте журнал CDN, правило доступу та повторні запити |
| Багато 404 від AI-агентів | Запитувані адреси не знайдені на цьому рівні | Що агент знайшов биті посилання саме зараз або що вся секція недоступна | Перевірте старі URL, редиректи, маршрути й походження адрес |
| Є ланцюжок 301 або 302 | Клієнт отримав один чи кілька редиректів | Що він завершив перехід на канонічну сторінку | Перевірте кінцевий URL та статус останнього кроку |
| Є статус 304 | Сервер повідомив, що ресурс не змінився відносно умовного запиту | Що в цьому рядку є повне тіло сторінки | Врахуйте кешування та попередню успішну відповідь |
| Є Googlebot, але немає інших AI User-Agent | Googlebot звертався в межах видимого вам журналу | Що інші сервіси не використовують сайт або що Google AI має окремого агента | Перевірте період, CDN і Google Search Console |
| На origin ботів немає, а Cloudflare показує їх | Edge зафіксував запити, яких не видно в origin-журналі | Що запит дістався застосунку чи отримав сторінку з origin | Зіставте edge-статус і дію кешу |
Є запит до llms.txt | Хтось попросив цей файл | Що файл прочитали або він вплинув на відповідь | Перевірте User-Agent, статус і вміст, не приписуючи вплив на цитування |
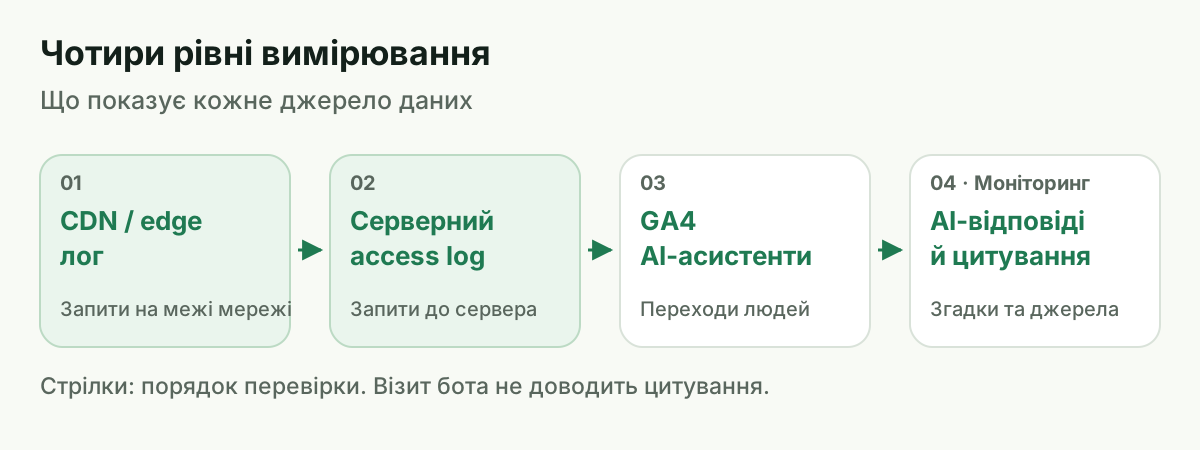
У цьому ланцюжку кожен інструмент відповідає на інше питання: edge бачить запити до CDN, access log фіксує звернення на серверному рівні, GA4 рахує переходи людей з AI-помічників, а моніторинг відповідей показує згадки та джерела. Про вимірювання людських переходів ідеться в матеріалі про трафік з AI-пошуку в GA4; сторінки, на які посилаються AI-відповіді, розбирає аналіз джерел відповідей ШІ. У дослідженні Vercel і MERJ на обмеженій вибірці сайтів не виявили виконання JavaScript основними AI-краулерами; результати опубліковано у грудні 2024 року. Це висновок для того періоду й вибірки, а не твердження про кожен сучасний агент.
Запис у логу також не гарантує, що клієнт виконав JavaScript. У дослідженні Vercel і MERJ, опублікованому в грудні 2024 року на обмеженій вибірці сайтів, автори не виявили виконання JavaScript основними AI-краулерами. Це спостереження для їхнього періоду й вибірки, а не актуальна гарантія для кожного агента або сайту.
Як відстежувати AI-ботів на сайті регулярно
Вибір інструмента залежить від обсягу журналів, формату та того, чи потрібен звіт у часі. Починайте з сирого логу, щоб розуміти, які саме події потрапили до обробки.
| Інструмент | Коли підходить | Обмеження |
|---|---|---|
grep, awk, zgrep | Разова перевірка чи невеликий журнал, коли відомий формат | Команди з цієї статті залежать від combined layout і потребують адаптації для JSON |
| GoAccess | Швидкий огляд вебжурналів і звіти з типових форматів | Спершу перевірте, чи правильно розпізнані поля User-Agent та часовий пояс |
| Screaming Frog Log File Analyser | Аналіз URL та бот-активності у веблогах | Перевірте актуальні умови ліцензії, межі імпорту та сумісність формату на сайті постачальника |
| Cloudflare AI Crawl Control | Активність AI-краулерів на сайтах за Cloudflare | Це дані edge-рівня; деталі невдалих запитів не означають автоматично блокування |
| ELK, OpenSearch або BigQuery | Великі журнали, регулярні агрегації та дашборди | Потрібні імпорт, схема полів і підтримка запитів до джерела |
Для активного сайту можна почати з щотижневого перегляду, для сайту з нечастими оновленнями достатньо щомісячного. Так можна відстежувати AI-ботів на сайті у власному часовому ряді. Після змін robots.txt, WAF, CDN або способу логування варто зробити позапланове порівняння. Це робоча рекомендація для процесу, а не галузевий стандарт.
У логах можуть бути IP-адреси й URL, які у певному контексті стосуються ідентифікованих людей. Recital 30 GDPR визнає IP-адреси онлайн-ідентифікаторами, що можуть бути персональними даними. Обмежте доступ до сирих файлів, зберігайте лише потрібний період і погодьте строк зберігання з політикою організації.
Типові помилки
- Шукати
Google-ExtendedабоApplebot-Extendedяк User-Agent і вважати, що пошукові роботи зникли. Це токени правил, а не окремі агенти у запитах. - Довіряти назві в User-Agent без перевірки IP. Її може надіслати будь-який клієнт.
- Дивитися лише origin log за наявності CDN, кешу або edge-блокування. Частина трафіку може завершитися раніше.
- Називати відвідування цитуванням. Серверний лог не містить фінальної відповіді моделі.
- Очікувати, що блокування
ChatGPT-Userчерез robots.txt зупинить запит. Правила для user-triggered fetch залежать від компанії й агента. - Порівнювати періоди в різних часових поясах або пропускати ротаційні
.gzфайли. - Робити висновок за одним сплеском без перевірки змін URL, sitemap, правил доступу й обсягу журналу.
Часті запитання
Як знайти GPTBot у логах сервера?
Для combined access log почніть із grep -i 'GPTBot' access.log, а далі згрупуйте рядки за URL, статусом і датою. Після цього перевірте IP за списком OpenAI, оскільки User-Agent можна підробити.
Як часто AI-боти відвідують сайт?
Універсальної норми немає. Виміряйте власну кількість запитів і унікальних URL по тижнях, розділіть агентів за роллю й порівнюйте періоди з однаковими налаштуваннями логування.
Що означають запити ChatGPT-User у логах?
Вони вказують на отримання сторінки за дією користувача в ChatGPT. Такий рядок не відкриває текст запитання і не підтверджує цитування URL у відповіді.
Як перевірити IP-адресу GPTBot?
Порівняйте адресу з актуальним JSON-списком OpenAI для GPTBot. Якщо сайт працює за проксі, спершу встановіть, чи це IP відвідувача або адреса самого проксі.
Чи означає візит GPTBot, що ChatGPT цитує сторінку?
Ні. GPTBot є окремим від пошукового OAI-SearchBot агентом; навіть підтверджений пошуковий запит не доводить, що сторінку використано у конкретній відповіді.
Чому в логах немає Google-Extended?
Google-Extended є токеном для правил обходу, а не назвою HTTP-бота. Запити Google Search, включно з AI Overviews та AI Mode, можуть надходити від Googlebot.
Як ми робимо це у VYDAI
VYDAI не читає серверні логи. GEO-аудит надсилає тестові запити з User-Agent окремих ботів, серед яких GPTBot, OAI-SearchBot, ClaudeBot, Claude-SearchBot, Claude-User, PerplexityBot і Perplexity-User, та показує, яку відповідь повернув сайт. Це перевірка поточної доступності сторінки, а не історія її відвідувань. Перелік перевірок можна переглянути в GEO-аудиті VYDAI.
Окремо VYDAI використовує дані GA4 про людські переходи з AI-помічників. Моніторинг відповідей показує, чи згадують ChatGPT, Gemini, Claude, Google AI Overviews та AI Mode бренд, і які джерела з'являються у відповідях. Це відповідає на інше питання, ніж журнал запитів. Для огляду моніторингу відкрийте демо VYDAI або зареєструйтеся.
Якщо потрібно перевірити відвідування сайту AI-ботами, лог покаже, чи приходив агент і яку відповідь отримав. VYDAI відповідає на інше запитання: чи потрапив бренд у відповіді AI та які джерела в них з'являються.