Чи однакові бренди рекомендують різні моделі ШІ? Лише частково. Топ-10 брендів двох різних моделей у ніші в середньому збігалися на 2,9–4,3 позиції з 10, а в дев'яти з 49 категорій жоден бренд не потрапив до топ-10 усіх трьох. Ми зіставили Claude Haiku 4.5, Gemini 3.1 Flash-Lite і GPT-5 nano через API без вебпошуку; це не споживчі застосунки ChatGPT, Gemini й Claude. Далі для стислості називатимемо їх Claude, Gemini і GPT. Вибірка: 50 однакових українських запитів на нішу, дев'ять хвиль із 14 червня до 6 жовтня 2026 року, 65 544 відповіді. Звіт за однією моделлю описує її власний ринок, тож скільки моделей ШІ варто моніторити, залежить від ніші: найсильніше списки розходяться в локальних послугах.
Як ми порівнювали рекомендації трьох моделей
Це дослідження рекомендацій брендів ChatGPT, Gemini і Claude використовує однаковий набір запитів для трьох API-моделей. Для OpenAI в тесті працював GPT-5 nano, а не модель, яка відповідає користувачам у застосунку ChatGPT.
| Що порівнювали | Як рахували |
|---|---|
| Вибірка | 49 публічних категорій, 50 українських промптів у кожній, три моделі |
| Період | Хвилі 3–11, дев'ять замірів із 14.06 до 06.10.2026 |
| Відповіді | 65 544 успішні відповіді з 66 150 запитаних |
| Покриття бренду | Частка успішних відповідей моделі в категорії, де згадано цей бренд |
| Топ-10 | Десять брендів із найбільшим покриттям для кожної моделі окремо |
| Перетин | Кількість однакових брендів у двох топ-10, від 0 до 10 |
| Jaccard | Спільні бренди, поділені на всі різні бренди у двох списках разом |
Перед порівнянням ми об'єднали низку очевидних варіантів написання, наприклад KFC Ukraine і KFC. Після нормалізації середній збіг пари зріс приблизно на 0,1 бренду, а кількість ніш без спільного бренду в усіх трьох списках зменшилася з 10 до 9. Частина варіантів могла залишитися невпізнаною, тому фактичний перетин може бути трохи більшим.
У цьому аналізі «рекомендація» означає, що бренд названо у відповіді. Ми не класифікували кожну згадку як схвальну пораду. Також не використовували офіційний бал рейтингу VYDAI: він враховує позицію бренду у відповіді, а тут рахувалася частка відповідей зі згадкою.
Наскільки збігаються рекомендації ChatGPT і Gemini
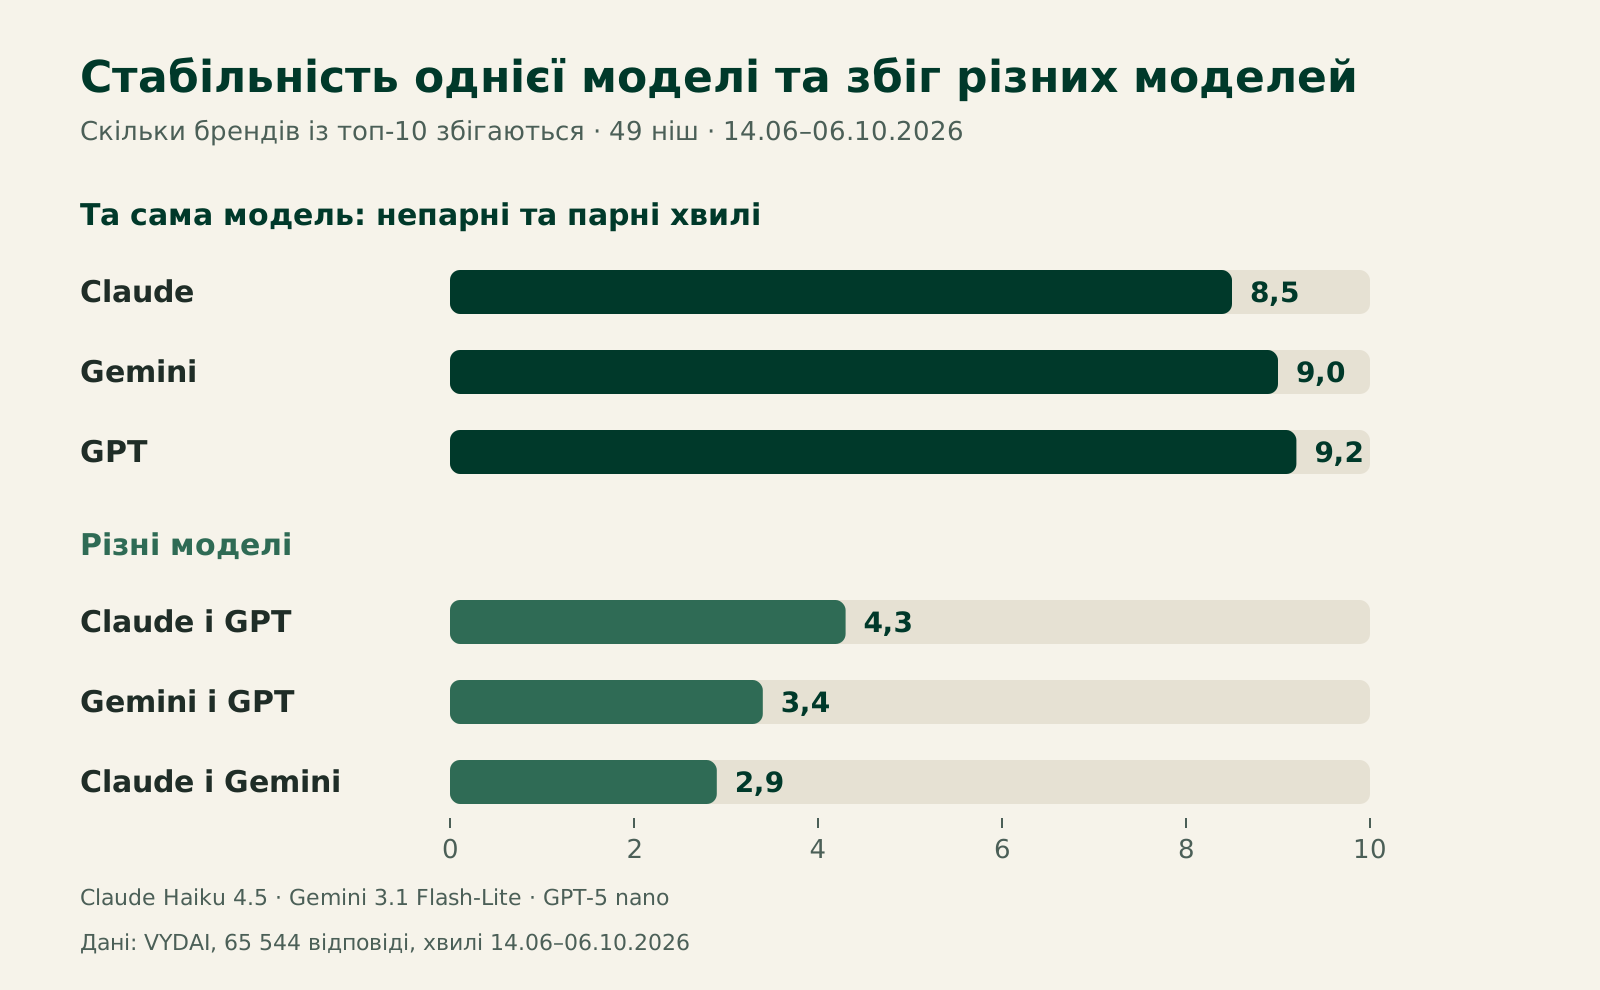
У нашому тесті цю пару представляли GPT-5 nano від OpenAI і Gemini 3.1 Flash-Lite від Google. Їхні топ-10 мали в середньому 3,4 спільного бренду з 10.
| Пара моделей | Середній перетин топ-10, бренду з 10 | Jaccard | Мін–макс по нішах | Ніш із нульовим перетином | Медіанний перетин |
|---|---|---|---|---|---|
| Claude і GPT | 4,3 | 0,30 | 0–8 | 2 | 4 |
| Gemini і GPT | 3,4 | 0,23 | 0–10 | 4 | 3 |
| Claude і Gemini | 2,9 | 0,19 | 0–8 | 5 | 3 |
Найчастіше збігалися списки Claude і GPT, найрідше Claude і Gemini. Проте навіть найбільше середнє значення становило менше половини топ-10. Перетин змінювався від нуля в окремих нішах до повного збігу Gemini й GPT в IT-аутсорсингу.
У 49 нішах було 1 470 місць у трьох топ-10, які зайняли 1 065 різних брендів. 23,8% місць припали на бренди, що потрапили до двох списків; ще 23,5% на 115 брендів, які є в топ-10 усіх трьох моделей. У середньому всі три топ-10 мали 2,35 спільного бренду на категорію. Дев'ять категорій не мали жодного такого бренду.
Як часто моделі ШІ рекомендують ті самі бренди? Трохи більше половини місць (52,7%) у трьох списках припали на бренд, який до топ-10 включила лише одна модель. Це не означає, що інші системи ніколи не згадували його нижче топ-10 або в інших відповідях.
Розбіжність не випадкова: кожна модель тримається свого списку
Щоб перевірити, наскільки збігаються рекомендації моделі сама з собою, ми розділили дев'ять хвиль на непарні й парні та окремо побудували топ-10 для кожної половини. У середньому Claude збігався сам із собою на 8,53 бренду з 10, Gemini на 9,04 бренду, GPT на 9,20 бренду. Коли порівнювали різні моделі на тих самих половинах періоду, середні перетини становили від 2,90 до 4,24 бренду.
Навіть у дев'яти нішах, де жоден бренд не був у топ-10 усіх трьох моделей, списки тієї самої моделі з різних половин періоду мали 7,44–8,56 збігів. У межах цього заміру різниця між моделями була виразнішою за рух списку кожної моделі між хвилями. Окрема відповідь, на відміну від агрегованого топ-10, змінюється значно сильніше: як це виміряти і скільки запитів потрібно, ми розібрали в дослідженні чому ШІ дає різні відповіді на той самий запит.
Це можна зіставити з дослідженням SparkToro про повторюваність рекомендацій. У ньому 600 учасників прогнали 12 промптів через ChatGPT, Claude і Google AI загалом 2 961 раз; автори пишуть, що шанс отримати двічі той самий повний список був меншим за 1 зі 100 для ChatGPT і Google AI. Наш результат не спростовує цей висновок: SparkToro порівнював цілі окремі відповіді на обмежену кількість промптів, а ми агрегували згадки у топ-10 за багатьма відповідями та хвилями.
Моделі можуть мати різні навчальні дані й дати надійного зрізу знань. За документацією Anthropic для Claude Haiku 4.5 його надійний зріз знань закінчується в лютому 2025 року; Google для Gemini 3 вказує січень 2025 року; OpenAI для GPT-5 nano вказує 31 травня 2024 року. Це можливі чинники, але наше дослідження не перевіряло, чи саме вони спричинили різницю. Порівняння пошуку, цитувань і доступу до джерел у пошукових версіях систем описане в окремій статті про те, як AI обирає бренди. У нашому тесті вебпошук був вимкнений.
Де моделі погоджуються: IT-аутсорсинг, електроніка, банки
Найбільше узгодження було там, де кілька відомих брендів часто з'являлися в різних відповідях. У IT-аутсорсингу вісім компаній були в топ-10 усіх трьох моделей. Списки Gemini й GPT збіглися повністю.
| Категорія | Claude і Gemini | Claude і GPT | Gemini і GPT | Усі три |
|---|---|---|---|---|
| IT-аутсорсинг | 8 | 8 | 10 | 8 |
| Електроніка | 6 | 6 | 7 | 6 |
| Мобільні оператори | 6 | 6 | 8 | 5 |
| Побутова техніка | 5 | 7 | 8 | 5 |
| Продукти та напої | 6 | 6 | 6 | 5 |
| Товари для дому | 5 | 7 | 5 | 5 |
| Турагентства й подорожі | 5 | 6 | 5 | 5 |
| Банки | 6 | 5 | 8 | 4 |
Спільна вісімка в IT-аутсорсингу: SoftServe, EPAM, Intellias, ELEKS, N-iX, DataArt, Sigma Software і Ciklum. Claude має по вісім спільних брендів із кожною іншою моделлю, тож навіть у цій узгодженій ніші два місця його списку відрізняються від списків Gemini й GPT. Про роботу над AI-видимістю B2B та IT-компаній ідеться в матеріалі GEO для B2B та IT.
Дев'ять ніш без жодного спільного бренду
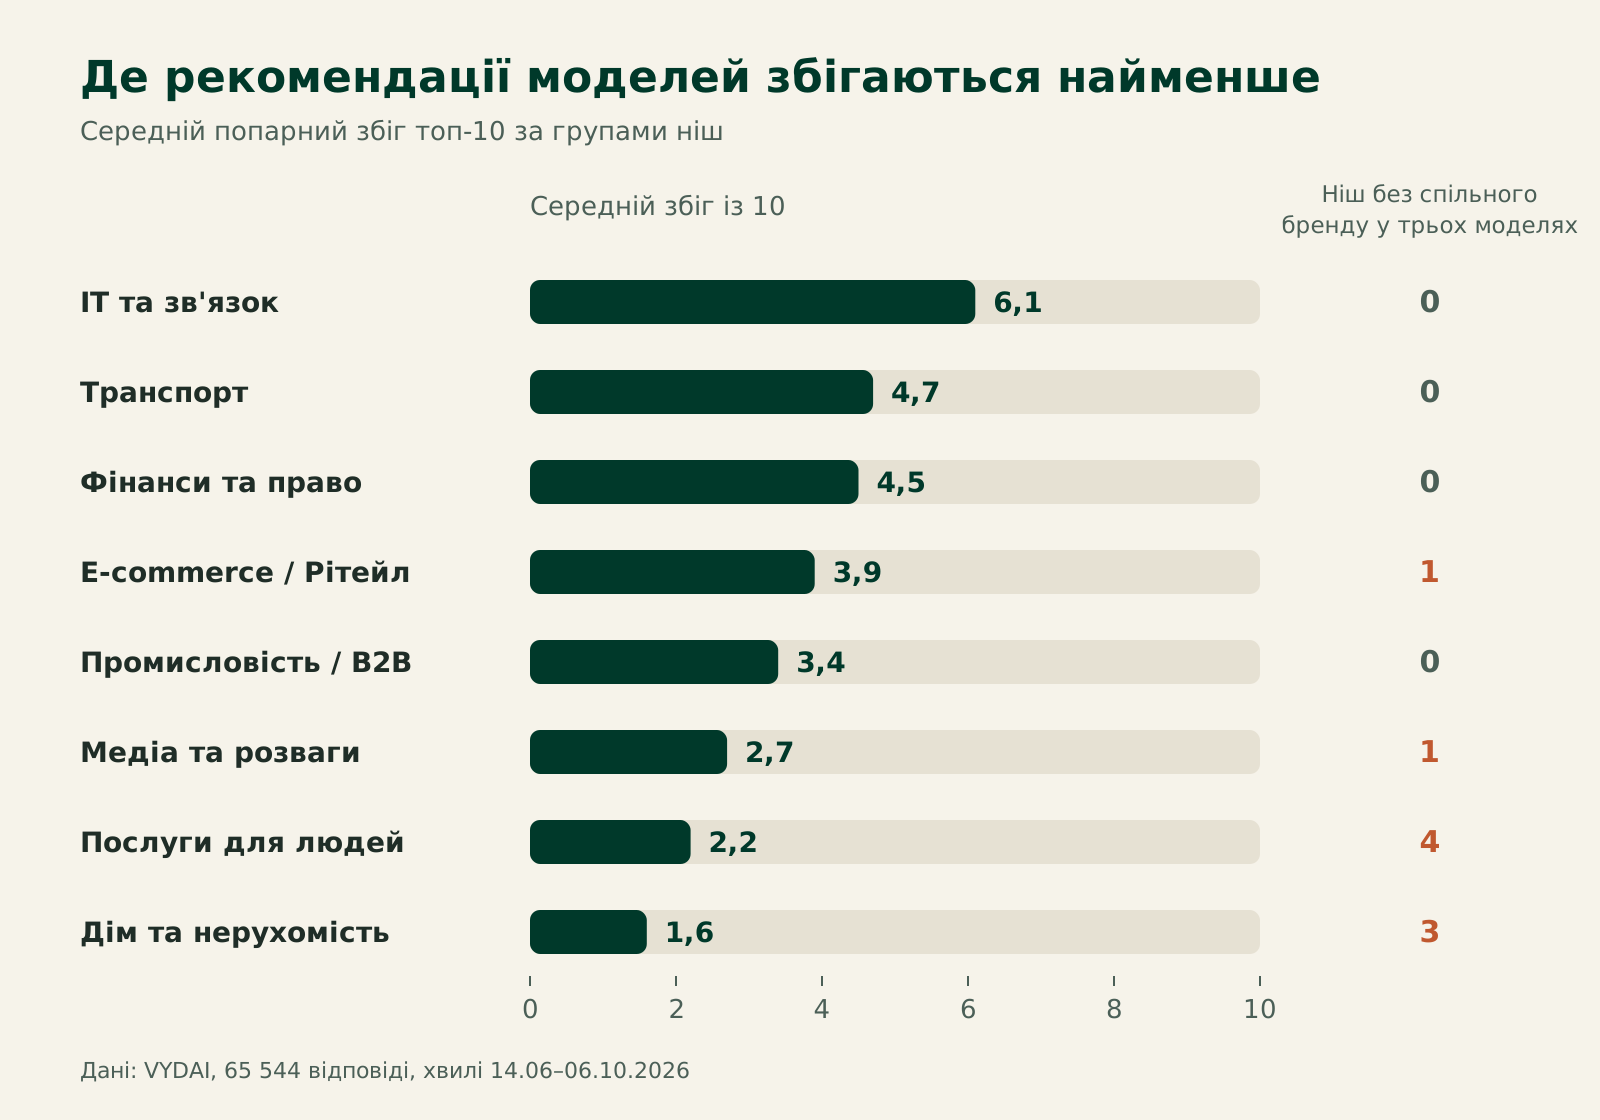
У дев'яти категоріях жоден бренд не увійшов до всіх трьох топ-10: салони краси та SPA, психологи й коучі, ландшафтний дизайн, ветеринарні клініки, видавництво й друк, побутові послуги, оптика, будівництво й ремонт, ресторани та кафе.
| Група категорій | Кількість ніш | Середній попарний перетин, з 10 | Ніш без спільного бренду у трьох списках |
|---|---|---|---|
| IT та зв'язок | 4 | 6,1 | 0 |
| Транспорт | 3 | 4,7 | 0 |
| Фінанси та право | 5 | 4,5 | 0 |
| E-commerce та рітейл | 16 | 3,9 | 1 |
| Промисловість та B2B | 4 | 3,4 | 0 |
| Медіа та розваги | 3 | 2,7 | 1 |
| Послуги для людей | 10 | 2,2 | 4 |
| Дім та нерухомість | 4 | 1,6 | 3 |
У ніші психологів і коучів об'єднання трьох топ-10 дало 30 різних назв із 30 місць. Gemini частіше називав Rozmova (44%) і Treatfield (34%), тоді як у топі GPT були міжнародні платформи Talkspace (22%) та BetterHelp (22%). Це різниця у відповідях моделей, а не оцінка якості послуг або фактичного вибору українських клієнтів.
У салонах краси списки також не мали перетину. Водночас GPT не дав коректної відповіді у 367 із 450 запитів цієї категорії. Тому порівнюємо лише успішні відповіді.
Чому розбіжність найбільша там, де немає явних лідерів
У категоріях, де топові бренди частіше з'являлися у відповідях, списки моделей мали більший перетин. Кореляція між середнім покриттям топ-10 брендів і середнім попарним збігом у 49 категоріях становила 0,74. Це зв'язок між двома показниками, а не доказ, що популярність спричиняє узгодженість.
| Середнє покриття топ-10 | Кількість ніш | Попарний перетин у середньому, бренду з 10 | Спільний бренд у всіх трьох, у середньому | Ніш без жодного спільного |
|---|---|---|---|---|
| Менше 25% | 15 | 1,67 | 0,73 | 9 |
| 25–40% | 15 | 3,67 | 2,47 | 0 |
| 40% і більше | 19 | 4,91 | 3,53 | 0 |
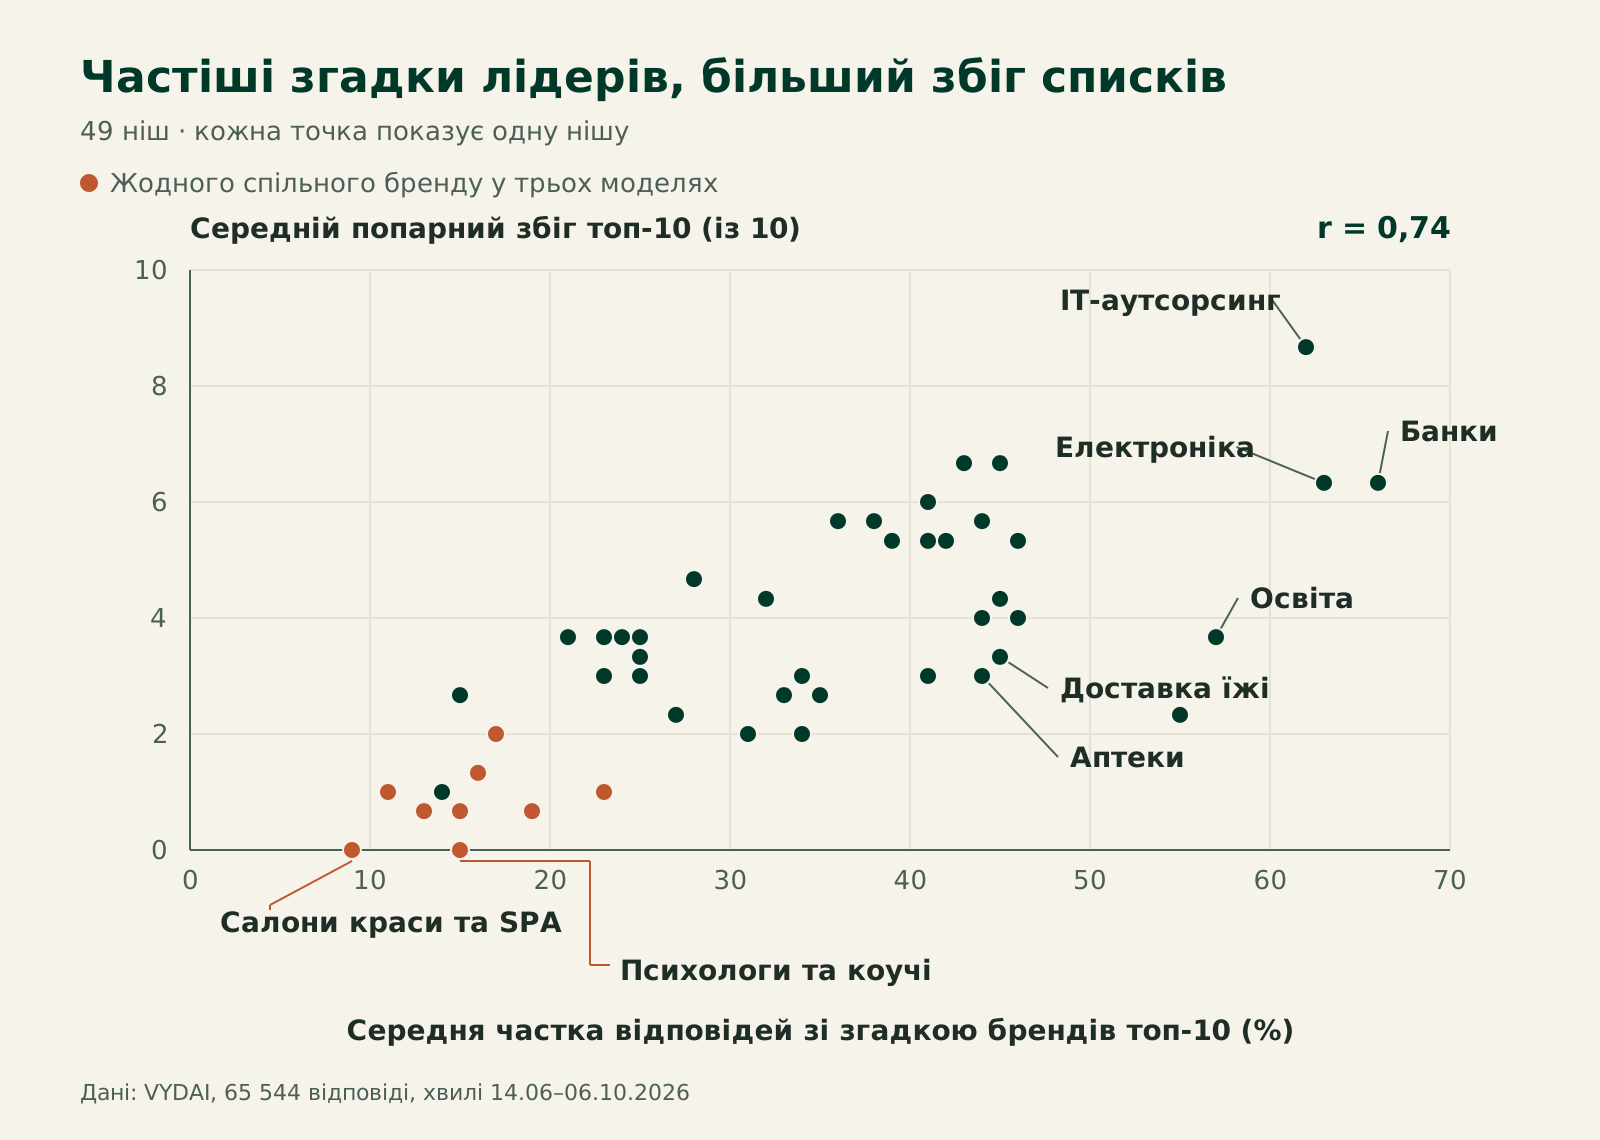
У низькому сегменті покриття всі дев'ять ніш без спільного бренду в усіх трьох списках. Практичне правило для маркетолога: якщо навіть найчастіші назви у відповідях трапляються менш ніж у чверті випадків, перевіряйте список кожної моделі окремо. Наприклад, найчастіший бренд у салонах краси з'являвся лише у 14% відповідей Claude і 26% Gemini; у банках лідера називали у 88–95% відповідей.
Правило працює в один бік: високе покриття не гарантує збігу. У страхуванні бренди топ-10 у середньому згадані в 55% відповідей, в освіті у 57%, але в обох нішах до топ-10 усіх трьох моделей потрапив лише один бренд. Кожна модель упевнено називає власних лідерів, і це видно на прикладі освіти нижче.
Аптеки, доставка їжі, освіта, банки: що радить кожна модель
Нижче наведені найчастіше згадані бренди. Їхня частка означає відсоток успішних відповідей конкретної моделі у відповідній категорії, а не частку ринку.
| Аптеки | Claude | Gemini | GPT |
|---|---|---|---|
| Перші п'ять | Apteka24.ua 56%, Apteka.ua 44%, Farmak 36%, Liki24 18%, eapteka.ua 16% | Подорожник 100%, АНЦ 99%, Доброго Дня 92%, Apteka.ua 90%, 9-1-1 85% | Apteka24.ua 97%, Watsons 86%, Apteka.ua 50%, Pharmacity 40%, eapteka.ua 39% |
Gemini називав офлайн-мережі аптек: Подорожник, АНЦ і «Доброго Дня». Claude та GPT частіше схилялися до онлайн-сервісів, серед яких Apteka24.ua, Liki24 та eapteka.ua. Подорожник мав 99,8% покриття у Gemini, 13,3% у GPT та 0,7% у Claude. У топі Claude також був Farmak, виробник ліків, а не аптечна мережа; у GPT 86% мав Watsons, мережа магазинів товарів для здоров'я й краси.
| Доставка їжі | Claude | Gemini | GPT |
|---|---|---|---|
| Перші п'ять | Uber Eats 94%, Wolt 78%, «Місцеві флористи через Glovo» 68%, 2GIS 37%, Bolt Food 24% | Glovo 88%, Bolt Food 86%, Mafia 70%, Domino's Pizza 54%, Sushi Master 45% | Glovo 87%, Uber Eats 86%, Wolt 62%, Eda.ua 52%, Foody.ua 47% |
Рядок «Місцеві флористи через Glovo» у топі Claude є артефактом відповіді або витягування бренду, а не окремим сервісом; ми не правили топ вручну. У відповідях Claude Uber Eats згадувався у 94% випадків, у GPT у 86%. Проте Uber повідомив про припинення роботи Uber Eats в Україні з 3 червня 2020 року. Wolt з'являвся у 78% відповідей Claude і 62% GPT, хоча в поточному списку країн Wolt України немає. Натомість Bolt Food має сторінку набору кур'єрів в Україні, а Gemini називав його у 86% відповідей. Згадка у відповіді моделі сама по собі не підтверджує, що сервіс зараз працює в країні. Чому моделі радять сервіси, які пішли з України, і що з цим робити бренду, ми окремо розібрали в дослідженні брендів-привидів у відповідях ШІ.
| Освіта | Claude | Gemini | GPT |
|---|---|---|---|
| Перші п'ять | Prometheus 80%, Coursera 72%, Udemy 58%, Skillbox 44%, Mate academy 36% | Projector 97%, Mate academy 96%, Hillel IT School 87%, GoITeens / GoIT 86%, Prometheus 84% | GoIT 93%, Prometheus 85%, Hillel IT School 82%, IT Step Academy 59%, Beetroot Academy 55% |
Projector згадувався у 97,3% відповідей Gemini, але у 1,8% Claude. Для Coursera частки становили 71,6% у Claude, 54,2% у GPT та 7,3% у Gemini. Prometheus був у топ-10 всіх трьох моделей із покриттям від 80,2% до 84,7%. Skillbox, російська онлайн-школа, мав 44,0% у Claude, 0,7% у GPT і не траплявся у відповідях Gemini. У дослідженні брендів-привидів для Claude вийшло 51%, бо там назви рахували за текстом відповіді, а не за списком, який витягує автоматичний екстрактор.
| Банки | Claude | Gemini | GPT |
|---|---|---|---|
| Перші п'ять | ПриватБанк 88%, ПУМБ 88%, Укрсиббанк 87%, OTP Банк 75%, A-Bank 72% | ПриватБанк 93%, ПУМБ 92%, Райффайзен Банк Аваль 91%, monobank 88%, Ощадбанк 88% | ПриватБанк 95%, Ощадбанк 93%, ПУМБ 83%, OTP Банк 70%, monobank 61% |
ПриватБанк був першим у всіх трьох списках, його покриття становило 88,2–94,9%. monobank був згаданий у 88,4% відповідей Gemini, 60,9% GPT і 4,9% Claude. Ощадбанк мав 93,1% у GPT, 87,6% у Gemini й 2,9% у Claude. Отже, навіть серед банків зі спільними лідерами видимість окремого бренду залежить від моделі.
Що показують інші дослідження
Результати можна порівняти лише з поправкою на різні промпти, моделі, спосіб збору та метрику.
| Джерело | Що порівнювали | Результат на сторінці дослідження | Чим відрізняється від нашого тесту |
|---|---|---|---|
| BrightEdge, червень 2026 | Топ-5 ChatGPT і Gemini за категоріями | Приблизно 2 спільні бренди з 5; у технологіях 4 з 5, у фінансах та страхуванні 1 з 5 | Інший набір категорій, два сервіси і щотижневі дані |
| Underneath Research, версія 1.1 | 80 запитань до чотирьох асистентів, лише явні рекомендації | Jaccard від 0,284 для ChatGPT і Claude до 0,355 для Gemini й Perplexity; 66,3% комбінацій «варіант і запитання» рекомендував лише один асистент | ChatGPT і Gemini через вебзастосунки з локацією США, Claude Haiku 4.5 і Perplexity через API з вебпошуком; один запуск на запитання |
| SparkToro, січень 2026 | Повторні запуски 12 промптів, 600 учасників, 2 961 відповідь | Повний список повторився з імовірністю меншою за 1 зі 100 у ChatGPT і Google AI | Вимірювали повторюваність окремих відповідей, а не топ-10 за хвилями |
У BrightEdge в кожній ніші збігалися близько двох брендів із п'яти, а наші пари мали від 2,9 до 4,3 спільного бренду з десяти. Це схожий напрямок, але числа не можна механічно зіставляти: вибірки й методики відрізняються. Наш контроль хвиль додає окрему перевірку: агреговані списки кожної моделі були стабільними навіть там, де самі моделі не погоджувалися між собою.
Скільки моделей ШІ варто моніторити
Якщо потрібно знати, кого називають різні системи, порівнюйте їх окремо. Почніть із моделей, якими користується ваша аудиторія, а в локальних нішах із низьким збігом перевіряйте всі доступні.
| Якщо ваша ситуація така | Практичне рішення |
|---|---|
| Клієнти можуть користуватися кількома асистентами | Відстежуйте кожну важливу для аудиторії модель окремо |
| У ніші є кілька сталих лідерів, як у банках, електроніці чи IT-аутсорсингу | Перевіряйте, чи відрізняються місця нижче лідерів; другий зріз можна робити рідше, якщо рішення не залежить від нього |
| Це локальна послуга без очевидного загального лідера | Не переносіть висновок з одного асистента на інші; порівнюйте всі доступні моделі |
| Потрібно зрозуміти зміну за місяць або квартал | Зберігайте однакові промпти, мову й період у повторних замірах |
Щоб зіставлення було коректним, зафіксуйте набір запитів і повторюйте його в однакових умовах. Про вибір таких запитів є окремий матеріал як підібрати промпти для моніторингу AI-видимості. Якщо конкурент є лише в одному з результатів, розберіть його контекст і джерела за інструкцією як зрозуміти, чому AI рекомендує конкурентів.
Рекомендації брендів ШІ в Україні варто читати окремо за моделями, а потім зіставляти. Простий перший крок: подивіться, як часто моделі називають лідерів вашої ніші. Якщо навіть вони згадуються менш ніж у чверті відповідей, один звіт залишає значну частину відмінностей поза полем зору, тож рахуйте видимість у кожній моделі окремо.
Обмеження дослідження
Ці результати описують конкретні API-моделі на фіксованих українських запитах. Вони не показують, як відповідають споживчі застосунки ChatGPT, Gemini чи Claude, де можуть відрізнятися модель, пошук, пам'ять, персоналізація та системні налаштування. Вебпошук у наших запусках був вимкнений.
Інструкція просила моделі назвати від 7 до 12 компаній. Бренди витягували з відповідей окремим кроком за структурованою схемою. Ми рахували частку успішних відповідей зі згадкою бренду, не тональність і не силу рекомендації. Тому «топ-10» тут означає найчастіші згадки за нашим правилом, а не обов'язково першу десятку явних порад.
У 24 із 147 списків був однаковий результат на межі десятого та одинадцятого місць; нічию розв'язували за абеткою нормалізованої назви. Це може змінити попарний перетин приблизно на один бренд. Нормалізація варіантів написання неповна, тож фактичний збіг може бути дещо вищим.
GPT-5 nano не завершив 601 із 22 050 запитаних відповідей. Збої були сконцентровані у локальних послугах, зокрема в салонах краси, у стоматології та серед психологів. Їх не зараховували як відповіді без брендів. Відтак частки й топ-10 для відповідної моделі розраховані лише за успішними відповідями.
Кореляція 0,74 між покриттям топ-брендів і перетином не доводить причинного зв'язку. Ми також не перевіряли, як зміниться результат із вебпошуком, іншою інструкцією, іншими промптами чи новішими версіями API-моделей. Висновки стосуються цих 49 категорій і періоду з 14 червня до 6 жовтня 2026 року.
Часті запитання
Чи однакові бренди рекомендують ChatGPT і Gemini?
Лише частково. У цьому порівнянні OpenAI представляв GPT-5 nano через API, а Google Gemini 3.1 Flash-Lite. Їхні топ-10 у середньому мали 3,4 спільного бренду з 10, а повністю збігалися лише в IT-аутсорсингу.
Чи збігаються рекомендації брендів ChatGPT і Claude?
Частіше, ніж інші пари, але менше ніж наполовину. Для GPT-5 nano та Claude Haiku 4.5 середній топ-10 перетнувся на 4,3 бренду з десяти, від 0 до 8 залежно від ніші.
Чи стосується результат застосунків ChatGPT, Gemini й Claude?
Ні. Ми тестували три API-моделі без вебпошуку. Результат не можна переносити на споживчі застосунки, які можуть мати інші моделі, пошук і персоналізацію.
Може, це просто випадковий шум?
За дев'ять хвиль у межах нашої вибірки топ-10 кожної моделі збігався між непарними та парними хвилями на 8,53–9,20 бренду з десяти, тоді як різні моделі мали лише 2,90–4,24 спільного бренду. Це стабільність агрегованих списків у цьому проміжку, а не гарантія незмінної окремої відповіді.
Скільки моделей ШІ варто моніторити?
Щонайменше ті, якими користується ваша аудиторія і від яких залежить ваш маркетинговий вибір. Якщо категорія локальна й без сильних лідерів, перевіряйте всі доступні моделі окремо: різниця там може бути найбільшою.
Чому цифри у рейтингу VYDAI можуть бути іншими?
Публічний рейтинг враховує позицію бренду у відповіді. У цьому дослідженні топ-10 сформований за частотою згадки бренду в успішних відповідях; ці два показники близькі за змістом, але не тотожні.
Як ми робимо це у VYDAI
На сторінках публічних рейтингів за нішами можна перемикатися між загальним зрізом і окремими вкладками ChatGPT, Claude та Gemini. Наприклад, подивіться IT-аутсорсинг, аптеки або доставку їжі. Рейтинг показує частоту й позицію брендів за своєю методикою, тож не є копією показника покриття з цього дослідження.
У робочому кабінеті VYDAI звіт конкурентів показує розбивку згадок і опис бренду окремо для кожної моделі, звіт джерел можна фільтрувати за моделлю, а приклад відповіді відкривається з промптом, датою й моделлю. Серед систем моніторингу VYDAI є ChatGPT, Gemini, Claude, Google AI Overviews і Google AI Mode. Perplexity до переліку не входить. Відкрити демо VYDAI або створити проєкт, щоб переглянути ці дані на своїх запитах.