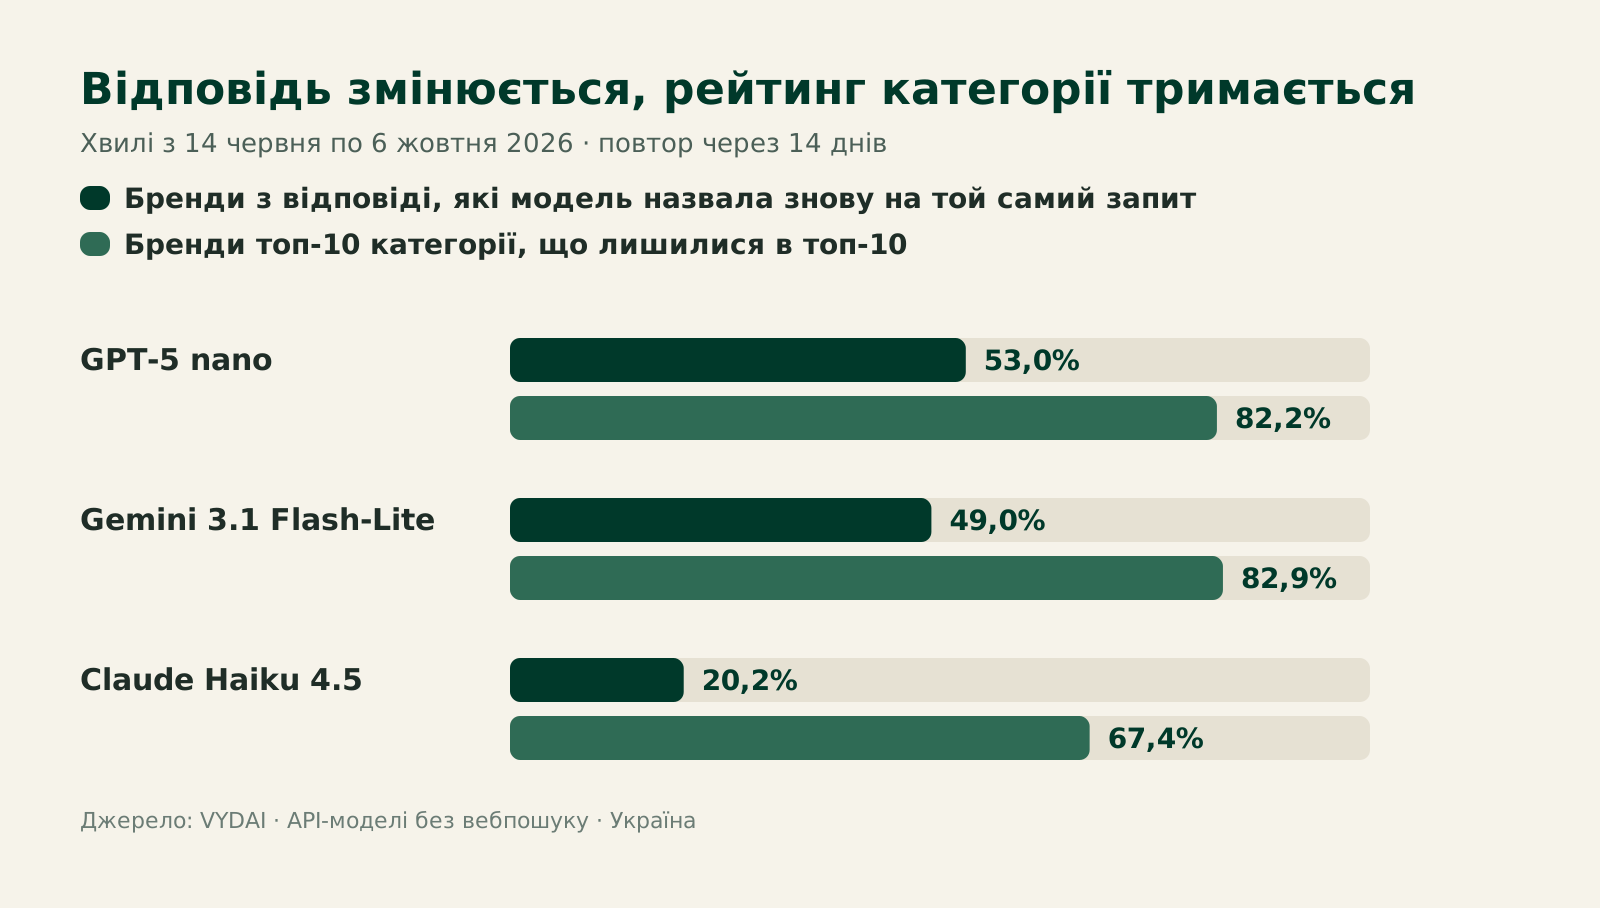
Чому ШІ дає різні відповіді на той самий запит? Ми повторили однакові запити в трьох моделях протягом п'яти місяців. Через два тижні в новій відповіді GPT-5 nano повторювалося в середньому 53% брендів із попередньої, у Gemini 3.1 Flash-Lite 49%, у Claude Haiku 4.5 лише 20%; у 41% повторів Claude не було жодного спільного бренду. Водночас категорійний топ-10, складений із 50 запитів, зберігав приблизно 8 із 10 брендів у GPT і Gemini та 6,7 з 10 у Claude. Отже, скриншот однієї відповіді не показує, чи є бренд у полі рекомендацій ніші. Ми проаналізували 65 544 відповіді трьох API-моделей без вебпошуку, а не відповіді споживчих застосунків ChatGPT, Gemini чи Claude.
Як ми вимірювали
Ми спостерігали за незмінним набором запитів у 49 категоріях українського ринку. Кожен запит надсилали окремим викликом до кожної моделі. Це дало змогу порівнювати, що змінилося у відповіді на той самий запит між сусідніми хвилями, а також що залишилося помітним у зведенні 50 запитів про категорію.
| Параметр | Дизайн дослідження |
|---|---|
| Категорії | 49 публічних тематик |
| Запити | 50 українських запитів на кожну категорію, ті самі в усіх хвилях |
| Моделі | GPT-5 nano, Gemini 3.1 Flash-Lite, Claude Haiku 4.5 |
| Період | 11 хвиль з 17 травня до 6 жовтня 2026 року, інтервал близько 14 днів |
| Основне вікно аналізу | Хвилі від 3 до 11, від 14 червня до 6 жовтня |
| Успішні відповіді в основному вікні | 65 544: 21 449 GPT, 22 050 Gemini, 22 045 Claude |
| Режим виклику | Окремий API-виклик на запит; temperature не задавали |
| Інструкція моделі | Назвати від 7 до 12 компаній; посилання лише за впевненості |
| Витяг брендів | GPT-5 nano перетворював відповідь на структуровані дані; аліаси брендів зводили словником |
Щоб порівняти дві відповіді на той самий запит, використали індекс Жаккара: кількість спільних брендів поділили на кількість унікальних брендів у двох списках разом. Значення 1 означає однаковий набір, 0 означає, що спільних назв немає. На рівні категорії рахували топ-10 брендів за кількістю відповідей, у яких вони з'явилися, а потім перевіряли, скільки з них лишилося в топ-10 наступної хвилі.
Той самий запит через два тижні: наскільки стабільні відповіді
Стабільність відповідей ШІ залежить від того, що саме порівнювати. Однаковий склад списку траплявся вкрай рідко. Але окремі бренди з попередньої відповіді з'являлися знову частіше, особливо у GPT та Gemini.
| Модель | Середній Jaccard між сусідніми хвилями | Немає спільного бренду | Повністю однаковий набір | Бренди з попередньої відповіді, що повторилися | Той самий бренд перший в обох відповідях |
|---|---|---|---|---|---|
| GPT-5 nano | 0,39 | 11,0% | 1,6% | 53,0% | 46,3% |
| Gemini 3.1 Flash-Lite | 0,36 | 5,5% | 1,4% | 49,0% | 60,0% |
| Claude Haiku 4.5 | 0,13 | 41,3% | 0,2% | 20,2% | 25,8% |
Тобто в GPT та Gemini повторювалася приблизно половина брендів із попередньої відповіді, але повністю однаковий список траплявся менш ніж у 2 випадках зі 100. У Claude у 41% пар не було жодного спільного бренду. І перше місце теж не було постійним: у GPT той самий бренд очолював обидва списки менш ніж у половині сусідніх пар. Щоб зрозуміти, чи рекомендує ChatGPT ті самі бренди щоразу, потрібні зіставні повтори, а не один скриншот.
За наміром запиту Jaccard майже не змінювався: від 0,38 до 0,41 для GPT, від 0,35 до 0,38 для Gemini і від 0,11 до 0,17 для Claude; запити на порівняння були трохи стабільнішими.
Зовнішній тест SparkToro та Gumshoe зібрав 2 961 відповідь волонтерів на 12 запитів у ChatGPT, Claude і Google AI. Автори повідомили, що шанс отримати однаковий бренд-список у двох відповідях був нижчим за 1 зі 100 для ChatGPT та Google AI, а той самий список у тому самому порядку траплявся рідше ніж 1 раз на 1 000. Один зі співавторів має комерційний зв'язок із Gumshoe. Важливий висновок для вимірювання полягає в тому, що автори рахували частоту появи брендів у багатьох відповідях, а не фіксували єдиний незмінний список, як описано в дослідженні SparkToro та Gumshoe про мінливість рекомендацій ШІ.
Це відрізняється від нашої попередньої перевірки смартфонів. Там 15 запитів до моделі GPT-5.6 Luna виконали по три рази з увімкненим вебпошуком і отримали середній Jaccard 67,1%. Тут інший період, інші API-моделі, 50 запитів на кожну категорію та вимкнений вебпошук. Тому 67,1% не суперечить результатам цієї панелі й не є показником для всіх відповідей ChatGPT. У дослідженні смартфонів ми окремо розібрали, які бренди смартфонів рекомендує ChatGPT в Україні.
Один запит, 11 відповідей: приклад із зоомагазинами
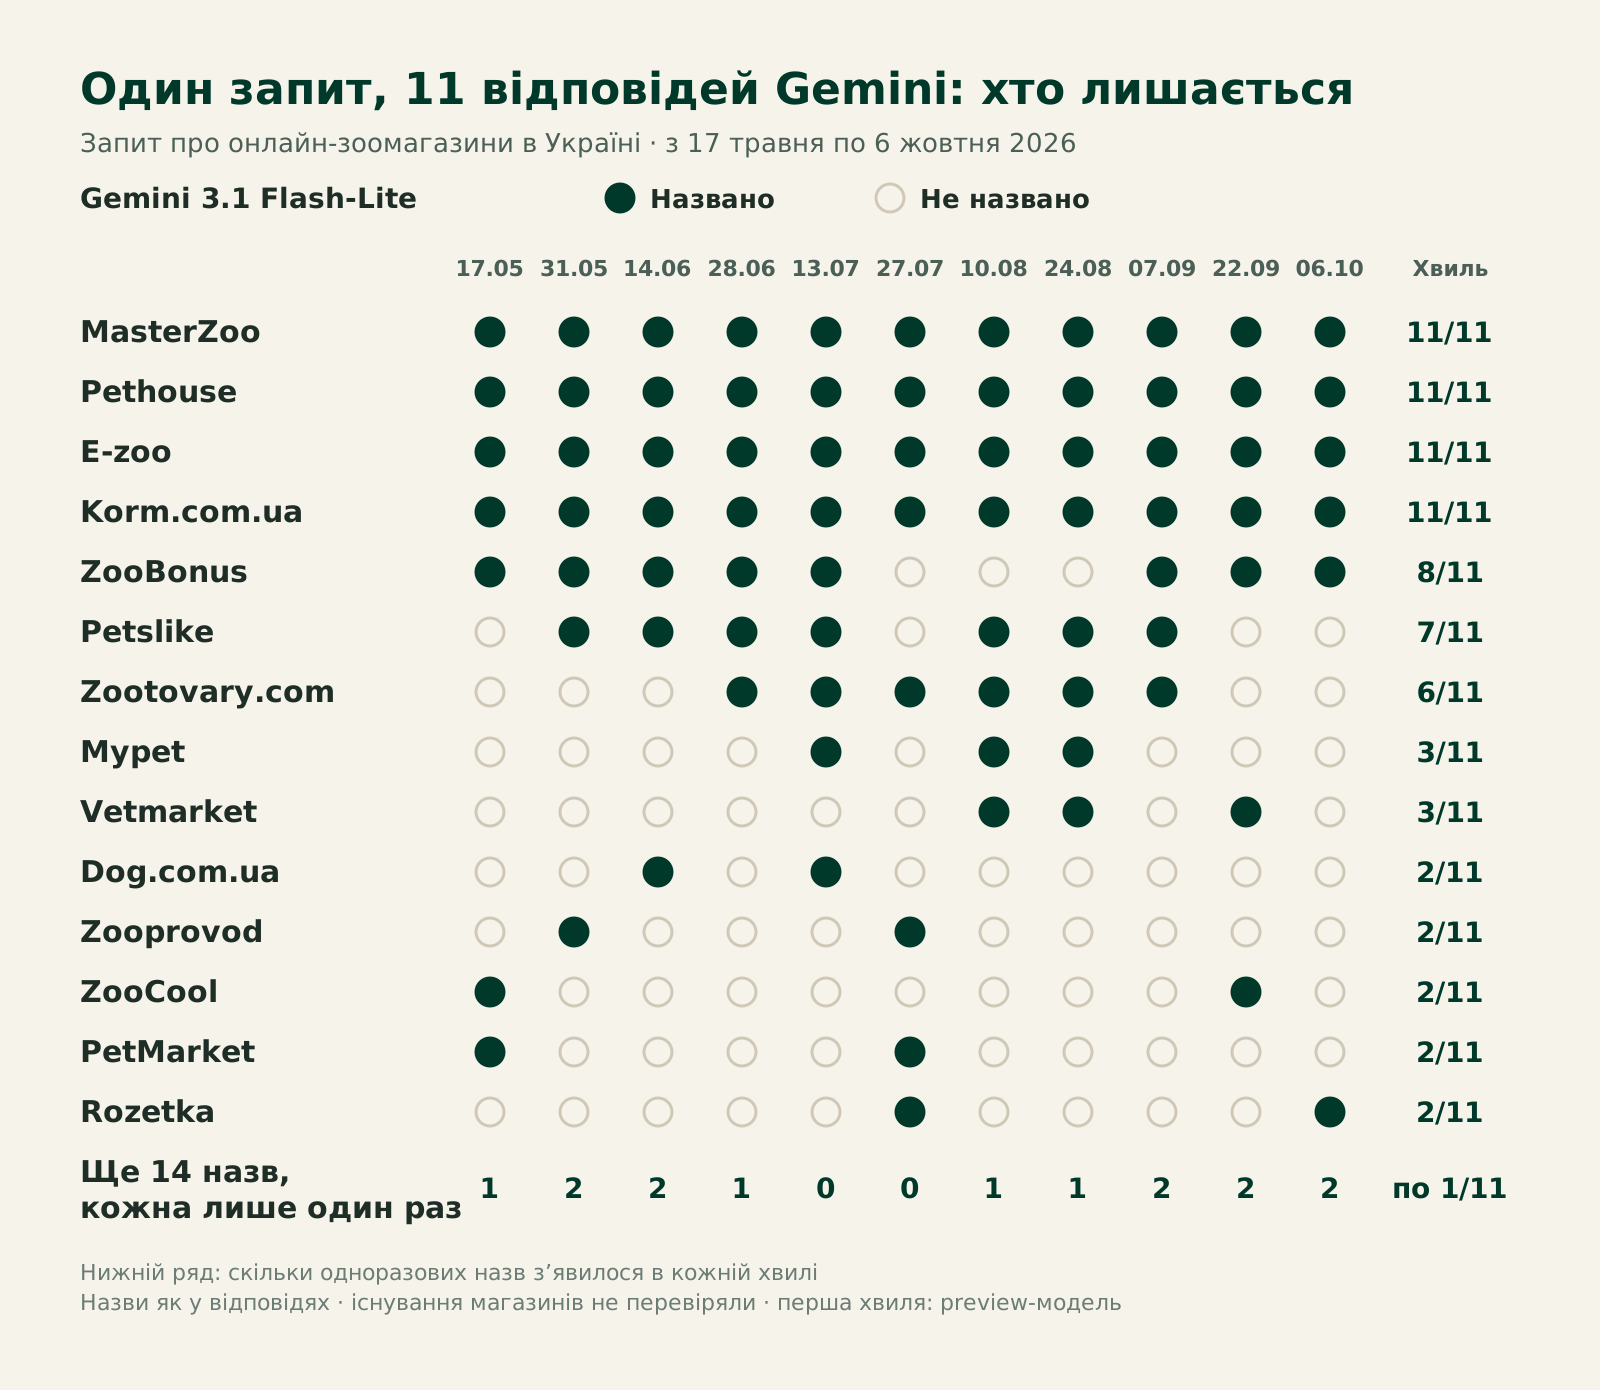
Один і той самий запит у різні дати давав різні набори брендів:
«Хочу знайти топ-зоомагазини онлайн в Україні з прозорими цінами та доставкою: порекомендуй найкращі компанії та їх сайти.»
Gemini назвав 28 різних брендів за 11 хвиль. Чотири бренди повторювалися в усіх відповідях: MasterZoo, Pethouse, E-zoo та Korm.com.ua. Ще 14 назв з'явилися лише один раз. Тож у цьому прикладі є і повторюване ядро, і довгий список одиничних згадок.
| Модель | Брендів у відповіді в середньому | Брендів за 11 хвиль | Є в кожній відповіді | Приклади частих згадок | Названі лише раз |
|---|---|---|---|---|---|
| Gemini 3.1 Flash-Lite | 8,6 | 28 | 4 | MasterZoo, Pethouse, E-zoo, Korm.com.ua; ще 3 бренди щонайменше в половині відповідей | 14 |
| GPT-5 nano | 4,9 | 23 | 0 | Rozetka у 9 відповідях, Prom.ua у 7 | 14 |
| Claude Haiku 4.5 | 7,4 | 65 | 0 | Petmart у 6 відповідях | 59 |
Ця таблиця описує один запит, а не рейтинг усіх зоомагазинів і не перевірку існування кожної названої компанії. Що це означає для власника магазину, видно на Petslike: Gemini назвав його в 7 з 11 відповідей, але не в двох останніх, 22 вересня і 6 жовтня. Хто перевірив би цей запит лише в жовтні, вирішив би, що Gemini магазин не знає. Хто перевірив би в серпні, побачив би його у списку. Обидва скриншоти правдиві, але жоден не показує частоту.
Скільки тут шуму, а скільки справжньої мінливості
Частина довгого хвоста справді могла бути результатом похибки витягу назв. GPT-5 nano структурував відповіді, а словник аліасів зводив різні написання до бренду. Така нормалізація не безпомилкова. У ручній перевірці 60 випадкових назв Claude, що з'явилися лише раз, були компанієподібні назви, які важко перевірити, приклади не з тієї категорії та обрізані чи дивно витягнуті назви. Це не дає підстав називати кожну рідкісну згадку вигадкою.
У частці згадок, що трапилися лише в одній відповіді категорії за дев'ять хвиль, різниця між моделями була значною: 31,2% для Claude, 7,9% для Gemini та 6,3% для GPT. Якщо рахувати бренди, що з'явилися менш ніж у десяти відповідях категорії, це були 54,2% брендів Claude, 25,1% Gemini та 18,7% GPT.
Ми також перерахували схожість після фільтрації брендів, які повторювались. Умови фільтра не доводять, що залишилися лише правильні бренди, а фільтр механічно збільшує перетин. Проте навіть серед назв, які повторилися щонайменше у 50 відповідях категорії за дев'ять хвиль, два списки одного запиту ділили лише близько половини брендів.
| Бренд лишається, якщо його назвали щонайменше | GPT: Jaccard | Gemini: Jaccard | Claude: Jaccard |
|---|---|---|---|
| Без фільтра, усі бренди | 0,39 | 0,36 | 0,13 |
| У 2 відповідях | 0,43 | 0,39 | 0,18 |
| У 10 відповідях | 0,50 | 0,46 | 0,30 |
| У 25 відповідях | 0,55 | 0,53 | 0,40 |
| У 50 відповідях | 0,59 | 0,60 | 0,49 |
Неверифіковані назви та посилання потребують окремої перевірки. У пов'язаному дослідженні ми розібрали, як часто ШІ вигадує посилання на сайти українських компаній. Для оцінювання присутності бренду важливо не змішувати якість назви, помилку витягу та нестабільність відповіді.
Чи змінюються рекомендації ШІ з часом: рівень категорії
На рівні окремого запиту список змінювався часто. На рівні категорії картина була стійкішою. Коли ми складали топ-10 на основі всіх 50 запитів однієї хвилі, у наступному двотижневому замірі в ньому залишалося в середньому 8,2 бренду для GPT, 8,3 для Gemini та 6,7 для Claude.
Із топ-10 хвилі 31 травня в топ-10 хвилі 6 жовтня лишилося 7,8 бренду в GPT, 8,2 у Gemini і 6,1 у Claude. Це майже стільки ж, скільки між сусідніми хвилями: 8,2, 8,3 та 6,7. Якби рекомендації поступово дрейфували, за п'ять місяців розбіжність була б набагато більшою, ніж за два тижні. Її немає, тож зміни між хвилями є коливанням навколо стабільного ядра. Стабільним виявився склад топ-10, а не кожен ранг. Тут ми порівнюємо одну модель саму з собою в часі; наскільки збігаються списки різних моделей між собою, показує окреме дослідження про те, чи однакові бренди рекомендують різні моделі ШІ.
| Модель | Топ-10, що лишився в наступній хвилі, у середньому | Топ-10 хвилі 2, що лишився у хвилі 11 | Той самий бренд на першому місці в наступній хвилі |
|---|---|---|---|
| GPT-5 nano | 8,22 з 10 | 7,84 з 10 | 64,3% |
| Gemini 3.1 Flash-Lite | 8,29 з 10 | 8,18 з 10 | 78,1% |
| Claude Haiku 4.5 | 6,74 з 10 | 6,12 з 10 | 56,6% |
Лідер категорії змінювався частіше, ніж склад топ-10. Один і той самий бренд лишався першим у кожній з дев'яти хвиль лише у 13 із 49 категорій GPT, 25 категоріях Gemini та 10 категоріях Claude. Тому зміна першого місця в одному замірі є слабким доказом, що ринок або видимість бренду змінилися.
Де рейтинг стабільний, а де його немає
Різниця між категоріями була не менш важливою за різницю між моделями. Середнє збереження топ-10 між хвилями в товарах для дому становило 9,6 бренду, в IT-аутсорсингу 9,3, в електроніці 9,3. У салонах краси та SPA лишалося 4,3, у ландшафтному дизайні 4,6, у ветеринарних клініках 4,7.
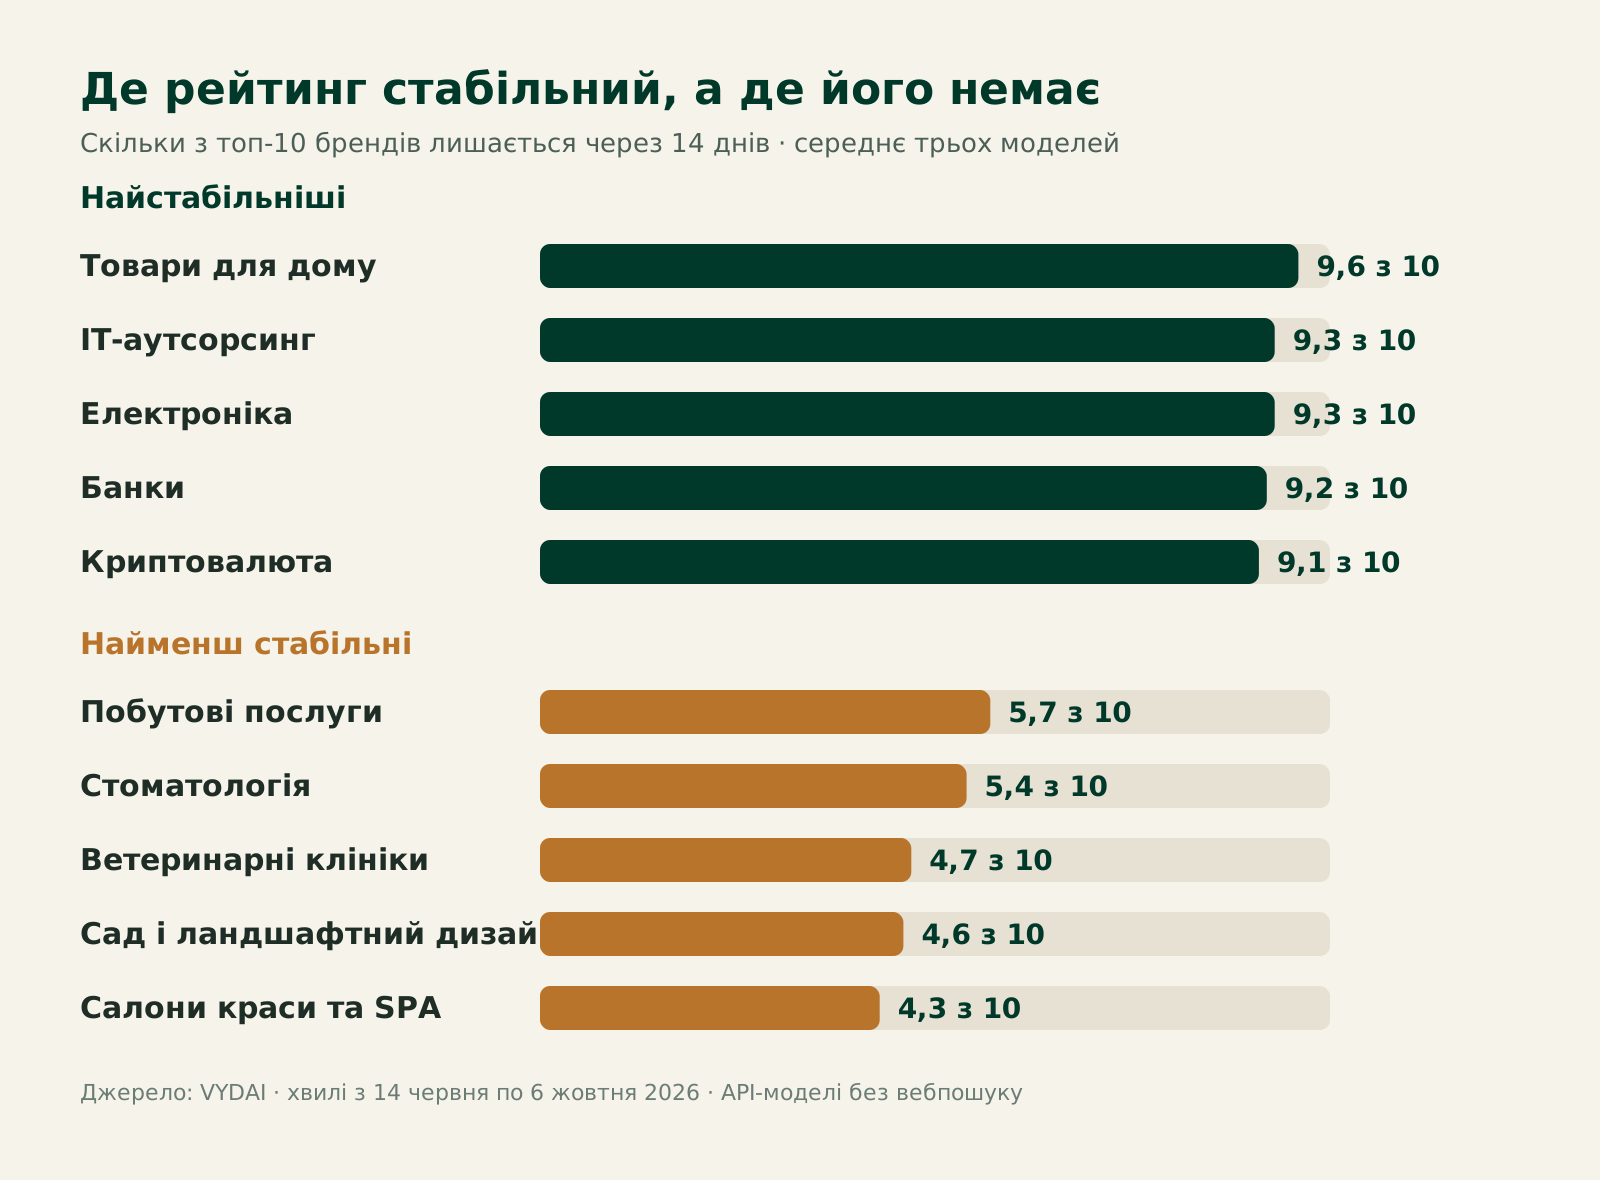
У банках лідер категорії з'являвся у 46 або 47 відповідях із 50, а бренд на десятому місці у проміжку від 13 до 18 відповідей. У салонах краси лідер з'являвся лише у проміжку від 4 до 13 відповідей, а десятий бренд від 2 до 6. У ветеринарних клініках GPT перший бренд називали приблизно чотири рази із близько 39 успішних викликів, а бренд на десятому місці приблизно один раз. У такій категорії різницю між місцями з шостого по десяте можуть створити одна чи дві згадки. Порівняти поточну картину можна у рейтингу банків та рейтингу салонів краси та SPA.
Коли ніша фрагментована, позицію від шостої до десятої не варто трактувати як твердий порядок ринку. Краще дивитися, у скількох запитах бренд з'являвся, які саме сценарії його згадували та чи повторюється його присутність у наступних хвилях. Якщо кілька відповідей не завершилися, наприклад у частині запитів про послуги, знаменник також має показувати успішні виклики, а не заплановані.
Чому ШІ дає різні відповіді на той самий запит
Мовна модель генерує відповідь послідовно, обираючи наступні токени за ймовірностями. Коли можливі кілька продовжень, інший вибір на початку може змінити і подальшу відповідь. У хостингових системах на результат можуть впливати й відмінності обчислення під час inference. У поясненні Thinking Machines Lab про недетермінізм LLM inference описано, як склад пакетної обробки запитів і неінваріантні обчислювальні ядра можуть породжувати відмінності навіть за однакового входу. Це технічний механізм, а не доказ, що саме він змінив будь-який конкретний бренд-список.
Чому ChatGPT дає різні відповіді
Користувацьке вікно чату може додавати до запиту попередні повідомлення, пам'ять, результати вебпошуку або інструментів. Через це два однаково написані повідомлення не обов'язково означають два однакові входи для моделі. Крім того, сервіс може змінити доступну модель або спосіб маршрутизації між двома датами. Це можливі пояснення різниці в інтерфейсі, а не чинники нашого API-порівняння. У нашому масиві версії моделей не змінювались після переходу Gemini з preview на загальну версію після першої хвилі, але склад відповідей все одно варіювався.
Чи дає temperature 0 однакові відповіді
Ні, це не універсальна гарантія. Anthropic у довідці Messages API вказує, що навіть за temperature 0 результати не будуть повністю детермінованими, а значення за замовчуванням становить 1,0. Саме з temperature 1,0 виконувалися наші виклики Claude. OpenAI пише, що відповіді за замовчуванням недетерміновані, а однаковий seed і ті самі параметри дають переважно детерміновані результати, хоча зміна серверної конфігурації, яку відстежує system_fingerprint, може змінити відповідь.
Документація Google про параметри Gemini пояснює, що temperature, topK і topP керують вибором наступних токенів, і для ранніх моделей Gemini 3, до яких належить 3.1 Flash-Lite, радить не змінювати значення за замовчуванням, щоб не погіршити якість міркування. У нашому дослідженні temperature не задавали. Отже, таблиці показують поведінку API з налаштуваннями провайдерів за замовчуванням, а не тест примусового режиму temperature 0.
Дослідження Ouyang та співавторів на задачах генерування коду показало, що temperature 0 зменшувала, але не усувала недетермінізм. У статті про недетермінізм ChatGPT у генеруванні коду йдеться про інший тип задач, але результат пояснює, чому фіксоване налаштування саме по собі не гарантує ідентичності.
«Я спитав ChatGPT, і нас там немає»: чому це не вимірювання
Скриншот показує одну відповідь на один запит у конкретному контексті. Він не показує, як часто бренд з'являється в інших запитах своєї категорії. У нашому зведенні бренд на десятому місці GPT був присутній лише в 16% окремих відповідей, для Gemini це було 16,7%, а для Claude 8%. Тобто навіть помітне місце у категорійному рейтингу не означає, що бренд має з'являтися у кожній відповіді.
| Місце бренду у категорійному рейтингу | GPT: частка відповідей, де бренд згаданий | Gemini | Claude |
|---|---|---|---|
| 1 | 74,4% | 69,1% | 40,7% |
| 3 | 52,0% | 44,7% | 26,7% |
| 5 | 34,2% | 33,1% | 14,9% |
| 10 | 16,0% | 16,7% | 8,0% |
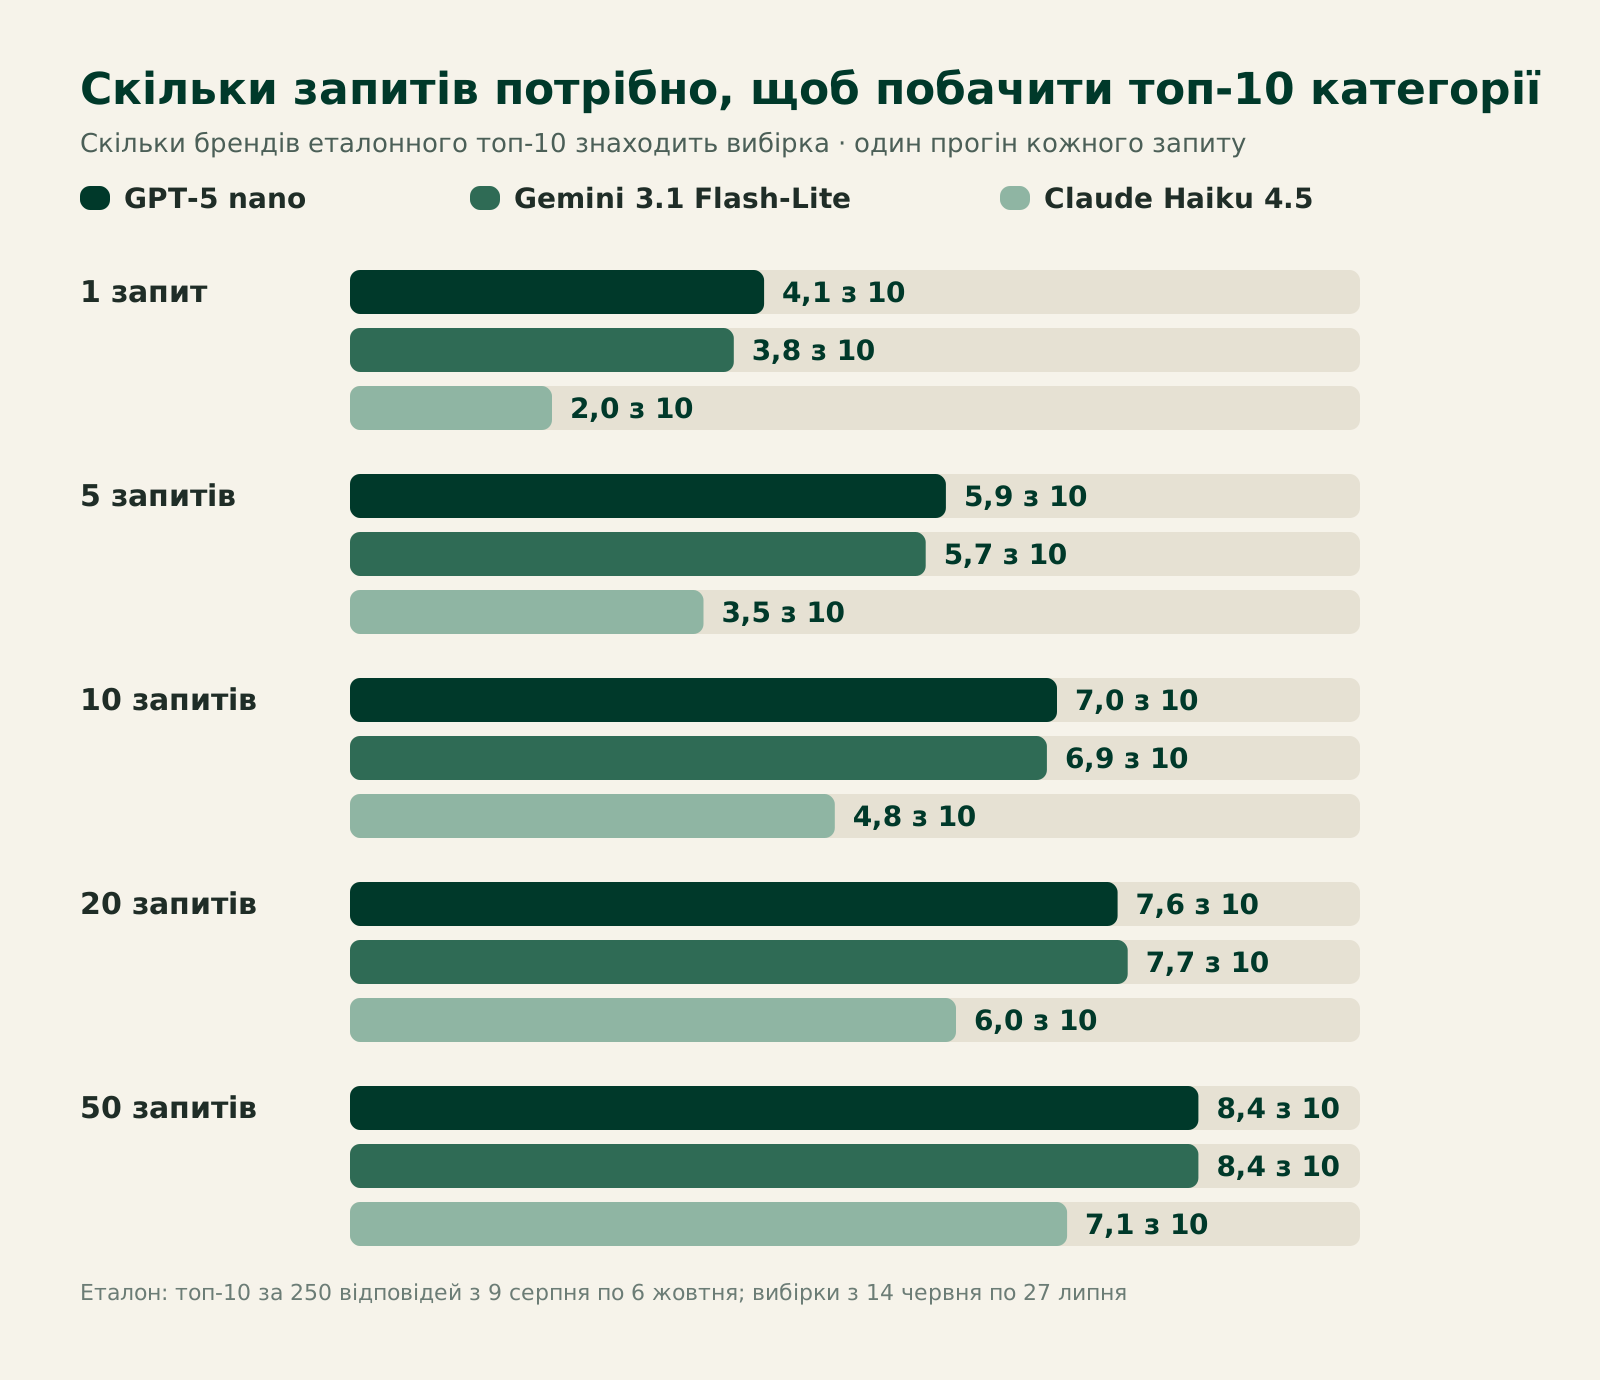
Один випадковий виклик відновив лише 4,1 з 10 брендів референтного топ-10 для GPT, 3,8 для Gemini та 2,0 для Claude в середньому. Імовірність побачити референтного лідера серед трьох перших у такому одиничному виклику становила 25%, 25% і 17%. Відсутність у відповіді означає лише, що бренд не назвали в цій конкретній відповіді. Це не підтверджує, що система ніколи його не рекомендує. Детальніше про інші причини відсутності бренду й перевірку контексту ми писали у матеріалі чому бренд не з'являється у ChatGPT, Gemini чи Claude.
Скільки запитів і повторів потрібно: розмір вибірки
Щоб побачити категорійний топ-10, за нашим ресемплінгом перший орієнтир такий: щонайменше 20 різних запитів на модель для первинної картини й 50 для рішення з вищою вимогою до покриття. Ці числа не є універсальним стандартом чи гарантією. Вони показують, скільки брендів з еталонного топ-10 відновлював випадковий набір у нашому дизайні.
У кожній категорії та для кожної моделі референтний топ-10 визначали за п'ятьма пізнішими хвилями, а випадкові вибірки формували з попередніх хвиль. Метрика проста: скільки з десяти референтних брендів потрапило до топ-10 малої вибірки. Кожен формат повторили 12 разів із різними випадковими доборами. Це вимірює збіг списків, а не статистичну похибку частки згадок.
| Різних запитів × хвиль повтору | Викликів | GPT: знайдено з 10 | Gemini: знайдено з 10 | Claude: знайдено з 10 |
|---|---|---|---|---|
| 1 × 1 | 1 | 4,1 | 3,8 | 2,0 |
| 1 × 4 | 4 | 5,0 | 4,5 | 2,9 |
| 5 × 1 | 5 | 5,9 | 5,7 | 3,5 |
| 5 × 4 | 20 | 7,1 | 6,9 | 5,7 |
| 10 × 1 | 10 | 7,0 | 6,9 | 4,8 |
| 10 × 2 | 20 | 7,5 | 7,4 | 5,9 |
| 10 × 4 | 40 | 7,9 | 7,7 | 6,6 |
| 20 × 1 | 20 | 7,6 | 7,7 | 6,0 |
| 20 × 2 | 40 | 8,0 | 8,1 | 6,8 |
| 20 × 4 | 80 | 8,3 | 8,4 | 7,4 |
| 50 × 1 | 50 | 8,4 | 8,4 | 7,1 |
| 50 × 2 | 100 | 8,7 | 8,7 | 7,7 |
| 50 × 4 | 200 | 8,9 | 8,8 | 8,1 |
За однакової кількості викликів додавання різних запитів давало кращий результат, ніж повторення меншої кількості запитів. Наприклад, 20 окремих запитів відновлювали 7,6 бренду GPT та 6,0 Claude. Ті самі 20 викликів як 5 запитів по чотири рази давали 7,1 і 5,7. Повтори все одно потрібні, коли питання саме у мінливості одного сценарію, але для початкового огляду категорії вигідніше розширити охоплення запитів.
50 різних запитів відновили в середньому 8,4 з 10 брендів GPT і Gemini, але 7,1 у Claude. Нижній дециль результатів був гіршим за середній: у вибірці 50×1 він дорівнював 7 для GPT, 7 для Gemini та 5 для Claude. Тож 50 запитів дають сильніший зріз, але не гарантують виявлення кожного важливого бренду. У нашому тесті для Claude потрібно було більше даних, щоб наблизитися до результату GPT чи Gemini.
Побудова самого пулу є окремою задачею. Якщо треба визначити його теми та формулювання, скористайтеся матеріалом як обирати запити для моніторингу AI-видимості. Тут важливо, що навіть добре зібраний пул треба оцінювати за достатньою кількістю різних запитів.
Довірчий інтервал для частки згадок
Якщо метрика це частка відповідей, де є конкретний бренд, її можна розглядати як оцінку пропорції. У своєму розрахунку потрібної кількості даних для одного запиту й однієї моделі комерційний постачальник інструментів для вимірювання AI-видимості Gumshoe наводить приблизно 97 повторів для похибки ±10 відсоткових пунктів і 385 для ±5 пунктів за наближеним 95% інтервалом. Формулу для інтервалу пропорції та альтернативні методи, зокрема Wilson, описує довідник NIST/SEMATECH.
Ці розрахунки стосуються частки згадок одного бренду в повторних відповідях за тим самим запитом. Їх не можна автоматично перенести на рейтинг топ-10, різноманітний пул запитів або схожість списків. У цих задачах відрізняється одиниця спостереження, а частота появи бренду залежить від теми запиту. Саме тому ми окремо перевірили розмір вибірки на референтному топ-10.
Як відрізнити шум від реальної зміни
Окремий зсув у таблиці варто перевірити, перш ніж міняти стратегію.
| Що змінилося | Як читати сигнал |
|---|---|
| Один бренд зник з однієї відповіді | Це не доводить втрату категорійної видимості. Перевірте інші запити цього наміру |
| У GPT чи Gemini за хвилю змінився один або два бренди у топ-10 | Це вкладається у середнє оновлення складу: у наступній хвилі лишалося близько 8 з 10 |
| У Claude за хвилю змінилося до трьох брендів топ-10 | Це теж звичайне оновлення: середнє збереження було 6,7 з 10. Порівняйте кілька наступних хвиль |
| У фрагментованій ніші послуг (салони краси, ветклініки) змінилася половина топ-10 | Там і в середньому лишалося 4,3–4,7 з 10. Дивіться, у скількох запитах бренд з'являється, а не на місця з шостого по десяте |
| Змінився бренд на першому місці | Той самий лідер повторився у наступній хвилі в 64% випадків GPT, 78% Gemini та 57% Claude. Перевірте наступну хвилю перед висновком |
| Рух видно в різних запитах і кількох замірах поспіль | Це сильніша підстава розбирати причину, ніж один скриншот |
| Змінився пул, модель, режим пошуку чи правило підрахунку | Спершу відновіть зіставні умови або позначте розрив у методиці |
У кожному вимірі записуйте текст запиту, модель, дату, режим пошуку, успішність відповіді та правило зведення брендів. Порівнюйте агреговані показники, а потім відкривайте окремі відповіді, що вплинули на зміну. Так легше відрізнити нову тенденцію від шуму добору. Це доповнює загальний підхід до метрик, описаний у матеріалі як вимірювати AI-видимість і читати її показники.
Якщо важливо побачити не лише різницю між двома хвилями, а зміну ринку, повторюйте той самий пул через однакові інтервали. У цій панелі хвилі йшли приблизно раз на 14 днів. Це інтервал нашого дослідження, а не універсальна частота для кожного бізнесу. Що дорожче рішення, яке команда ухвалює за даними, то важливіше мати достатню кількість незалежних спостережень і кілька зіставних замірів.
Обмеження дослідження
Результати описують 65 544 успішні відповіді API-моделей GPT-5 nano, Gemini 3.1 Flash-Lite та Claude Haiku 4.5 на редакційно складений пул українських запитів. Вебпошук був вимкнений у всіх викликах. Це не вибірка всіх запитів людей і не спостереження за застосунками ChatGPT, Gemini чи Claude. У споживчому інтерфейсі до видимого тексту можуть додаватися історія, пам'ять, пошук, маршрутизація чи оновлена модель.
Основні показники схожості рахували для хвиль від 3 до 11. Gemini перейшов із preview на загальну версію після першої хвилі, а далі версії не змінювалися. Ми не задавали temperature, а використовували параметри провайдерів за замовчуванням. Бренди витягувала окрема модель, а словник аліасів не прибирає всіх неоднозначностей. Частину довгого хвоста складно перевірити; не кожна одинична згадка є помилкою або вигадкою.
У деяких категоріях було менше успішних викликів GPT, особливо для послуг. Рівність на десятому місці розв'язували зафіксованим правилом; у близьких позиціях можливий інший порядок. Референтний топ-10 для ресемплінгу сам побудований за обмеженим періодом, тому є еталоном цього експерименту, а не остаточним переліком найкращих брендів ніші.
Нарешті, згадка бренду не означає рекомендацію, правильність характеристик чи якість продукту. Вона показує лише, що назва була в тексті відповіді за конкретних умов. Для маркетингового рішення перевіряйте також зміст, контекст і джерела відповіді.
Часті запитання
Чому ChatGPT дає різні відповіді?
Модель генерує новий текст, а в чаті на результат можуть також впливати історія розмови, пам'ять, пошук і доступна версія моделі. У нашому тесті API-виклики були без вебпошуку, однак набори брендів теж змінювалися.
Чи дає temperature 0 однакові відповіді?
Ні, не гарантує. Anthropic вказує, що навіть за нульового temperature повної детермінованості немає. OpenAI називає результат з однаковим seed і параметрами лише переважно детермінованим, бо зміна серверної конфігурації теж може змінити відповідь.
Чи змінюються рекомендації ШІ з часом?
Окремі відповіді змінюються постійно, а склад категорійного топ-10 майже не дрейфує. Із топ-10 кінця травня на початку жовтня лишалося 7,8 бренду в GPT, 8,2 у Gemini і 6,1 у Claude. Це майже стільки ж, скільки за два тижні: 8,2, 8,3 і 6,7.
Який розмір вибірки для вимірювання AI-видимості обрати?
У нашому ресемплінгу 20 різних запитів дали перший орієнтир, а 50 краще відновлювали топ-10 GPT і Gemini. Для Claude відновлення було слабшим. Це орієнтири саме для цього дизайну, а не універсальна гарантія.
Чому ChatGPT рекомендує різні бренди?
У дослідженні SparkToro та Gumshoe однаковий список рекомендацій траплявся менш ніж у 1 зі 100 пар відповідей для ChatGPT та Google AI. У нашій панелі той самий запит через два тижні мав Jaccard 0,39 для GPT, 0,36 для Gemini і 0,13 для Claude. Модель щоразу заново обирає кілька назв із ширшого кола ймовірних кандидатів: стабільне ядро повторюється, а решта списку змінюється.
Як перевірити повторюваність відповідей ChatGPT?
Запустіть той самий набір різних запитів кілька разів за однакових умов і порахуйте, як часто з'являється кожен бренд. Одного скриншота недостатньо. У нашому ресемплінгу 20 різних запитів відновили близько 7,6 з 10 брендів GPT та 6,0 Claude, а 50 запитів дали 8,4 для GPT та Gemini і 7,1 для Claude.
Як тлумачити довірчий інтервал для частки згадок?
Він описує невизначеність оцінки того, як часто бренд з'являється у відповідях. Формула для однієї моделі й одного запиту не є формулою точності всього рейтингу категорії. Для топ-10 використовуйте окрему перевірку на вибірці та зіставляйте кілька хвиль.
Як ми робимо це у VYDAI
Публічний рейтинг AI-видимості за категоріями показує, які бренди з'являються у відповідях моделей OpenAI, Anthropic і Google, і як змінюється їхня видимість між замірами. Наприклад, у рейтингу зоотоварів можна переглянути категорійний список і динаміку. Публічні рейтинги оновлюються за пулом із 50 запитів на категорію приблизно раз на два тижні.
У VYDAI ви додаєте власний пул запитів, а система регулярно запускає їх у кількох AI-системах і показує згадки бренду, частку голосу, конкурентів поруч та динаміку між замірами. Для невеликої ручної перевірки достатньо почати з 20 різних запитів і зберегти однакові умови для кожного заміру. Перегляньте демо VYDAI або створіть обліковий запис, щоб подивитися, як це працює.